

ChatGPTに文章を入力すると、AIがその文章をそのまま読んで、意味を理解しているように見えます。たとえば「この文章を要約してください」と入力すれば、自然な日本語で返事が返ってきます。
しかし、LLM(大規模言語モデル)は、入力された文章をそのままの文字列として処理しているわけではありません。モデルに入る前に、文章はいったん「トークン」と呼ばれる小さな単位に分けられます。そして、それぞれのトークンは「トークンID」と呼ばれる数字に変換されます。
LLMにとって文章は、文字の並びというより、トークンIDの列です。私たちが自然に読んでいる文章も、モデルの内部ではこのような数値の列として扱われます。
トークンは少し地味な概念ですが、入力できる文章量、長文処理、日本語の扱いやすさなど、実用上のさまざまな場面に関わっています。
1.AIは文章をそのまま読んでいるわけではない
人間は文章を読むとき、文字や単語をかなり自然に扱えます。日本語の文にはスペースがありませんが、私たちは経験から、どこで意味が区切れるのかをほとんど意識せずに判断しています。
一方で、LLMは最初から文章の意味をそのまま理解しているわけではありません。コンピュータが直接扱えるのは、文字そのものではなく数値です。そのため、文章をモデルに入力する前には、次のような変換が行われます。
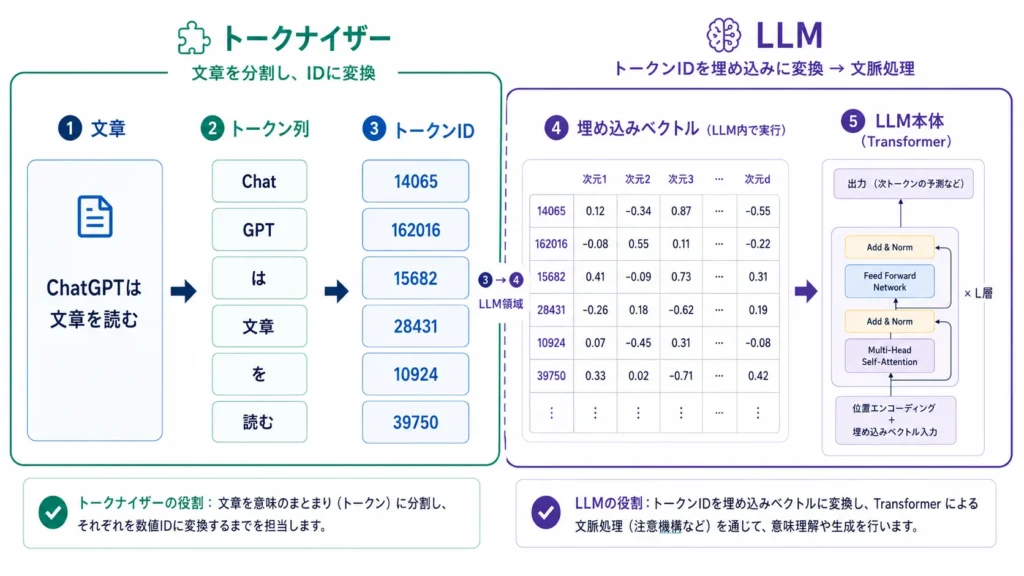
まず、入力された文章はトークナイザーによってトークン列に分けられます。トークンとは、モデルが文章を扱うための基本的な部品です。これは必ずしも単語とは限りません。1文字の場合もあれば、単語の一部、記号、空白を含むまとまりになることもあります。
次に、それぞれのトークンは トークンID という数字に変換されます。モデルは「こんにちは」という文字列をそのまま受け取るのではなく、「このトークンは何番」という形で受け取ります。
ここで大事なのは、トークンIDは「意味を表す数字」ではないということです。トークンIDは、いわば辞書の見出し番号のようなものです。多くのTransformerベースの言語モデルでは、モデル内部に、各トークンに対応するベクトルを並べた 埋め込み表(embedding table) があり、トークンIDは「その表の何番目の行を取り出すか」を示します。
たとえば、実際の番号はトークナイザーによって変わりますが、イメージとしては次のようになります。
"Chat" → トークンID 14065 → 埋め込み表の14065番目のベクトル
"GPT"  → トークンID 162016 → 埋め込み表の162016番目のベクトル
つまり、トークンIDは文字列とベクトルのあいだをつなぐための番号です。そのIDをもとに 埋め込みベクトル が取り出されます。埋め込みベクトルとは、トークンを数百〜数千個の数値の配列として表したものです。この数値の配列を使うことで、ようやくTransformerなどのモデル本体が計算できる形になります。
このように、LLMに入力された文章は、そのままの文字列として処理されるのではなく、トークン列、トークンID列、埋め込みベクトル列へと変換されていきます。
ここで重要なのは、モデルが直接扱うのは文章そのものではなく、トークンをもとにした数値表現だということです。トークンは、人間が読む文章と、モデルが計算できる数値表現をつなぐための基本単位だと言えます。
次の章では、このトークンという単位が、単語や文字とどう違うのかを具体例で見ていきます。
2.トークンとは何か
トークンとは、LLMが文章を扱うための基本単位です。
ここで注意したいのは、トークンは「単語」と同じものではないという点です。人間にとって自然な単語の区切りと、モデルにとって扱いやすい区切りは、必ずしも一致しません。トークンは、1文字の場合もあれば、単語の一部、単語のようなまとまり、記号、空白を含むまとまりになることもあります。
たとえば、あるトークナイザーでは、次のように分割されます。
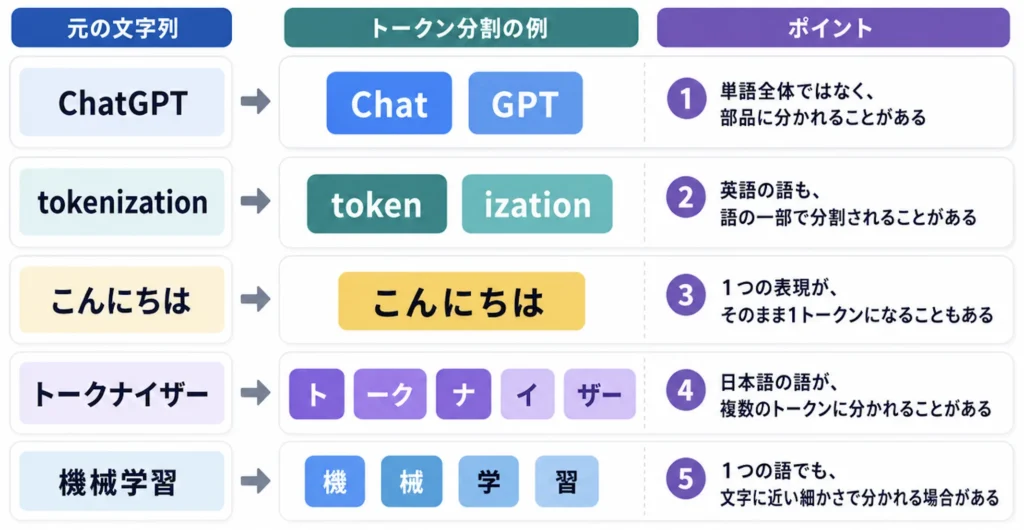
この例を見ると、トークンが単語と同じではないことが分かります。ChatGPT や tokenization は単語全体ではなく部品に分かれています。一方で、こんにちは のように1つの表現が1トークンとして扱われることもあれば、トークナイザー や 機械学習 のような日本語の語が細かく分かれることもあります。
ただし、ここで示した分割は一例です。実際の分かれ方は、使っているモデルやトークナイザーによって変わります。同じ 機械学習 という文字列でも、あるトークナイザーでは細かく分かれ、別のトークナイザーではより大きなまとまりとして扱われるかもしれません。
トークンは、トークナイザーが持っている語彙表に登録されています。語彙表とは、「この文字列のまとまりを1つの部品として扱う」という一覧表のようなものです。たとえるなら、語彙表は辞書で、トークンIDはその辞書の見出し番号です。モデルは文章そのものを直接読むのではなく、切り出された部品と、その番号を使って処理を始めます。
この仕組みのおかげで、モデルは文章を数値の列として扱えるようになります。一方で、どの文字列を1つの部品として登録するかは、かなり大事な設計です。よく出てくる表現を毎回細かく分けてしまうと、文章が長いトークン列になってしまいます。逆に、単語をそのまますべて登録しようとすると、語彙表が大きくなりすぎたり、見たことのない新しい言葉に弱くなったりします。
そこで多くのトークナイザーでは、単語そのものではなく、もう少し柔軟な サブワード という単位が使われます。次の章では、なぜ単語単位でも文字単位でもなく、サブワードに分けることが多いのかを見ていきます。
3.単語ではなく「サブワード」に分ける理由
文章をトークンに分ける方法として、まず思いつきやすいのは「単語ごとに分ける」方法です。英語ならスペースで区切られていることが多いので、I like machine learning を I、like、machine、learning のように分ける発想は自然に見えます。
しかし、単語単位のトークン化には大きな問題があります。世の中には新しい固有名詞、専門用語、商品名、略語、表記ゆれが次々に出てきます。それらをすべて語彙表に登録しようとすると、語彙表が非常に大きくなります。逆に、語彙表にない単語が出てきたときには、その単語をうまく扱えなくなります。
では、文字単位で分ければよいのでしょうか。文字単位なら、知らない単語が出てきても、ひらがな、漢字、アルファベットなどの文字に分解できます。その意味では未知語に強い方法です。
ただし、文字単位には別の問題があります。文章が細かく分かれすぎて、トークン列が長くなりやすいのです。たとえば tokenization を1文字ずつ分けると、t、o、k、e、n、… という長い列になります。モデルが処理するトークン数が増えるほど、計算量も増え、同じコンテキスト長に入れられる文章量も少なくなります。
そこで使われるのが サブワード という考え方です。サブワードは、単語より小さく、文字よりは大きいことが多い単位です。よく出てくるまとまりは大きめのトークンとして扱い、珍しい語や新しい語は小さな部品に分けます。
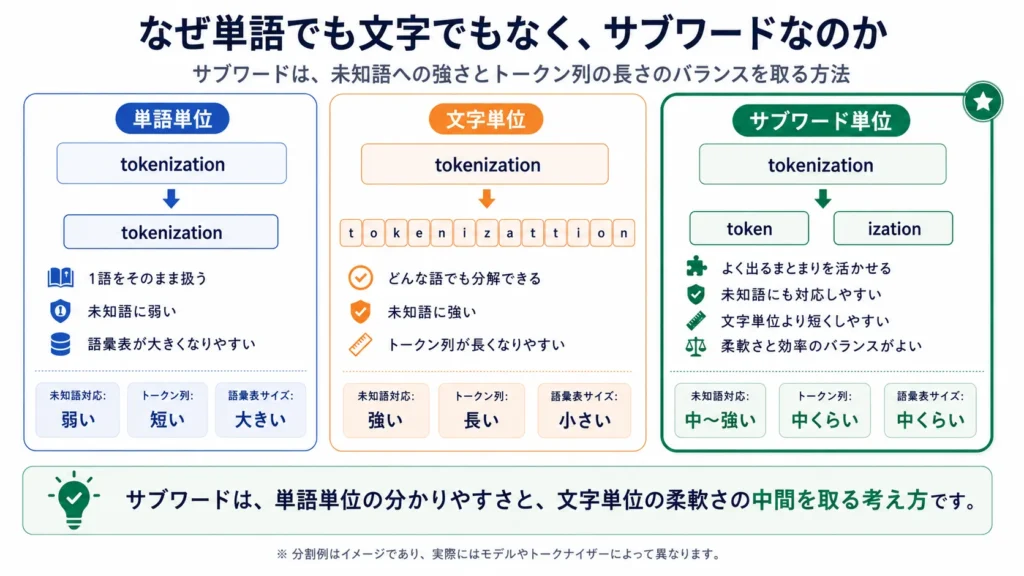
たとえば tokenization が token と ization に分かれるのは、単語全体を1つとして扱うのではなく、意味や出現頻度のある程度まとまった部品として扱っている例です。これにより、単語単位より未知語に対応しやすく、文字単位よりトークン列を短くしやすくなります。
実際のトークナイザーでは、BPE(Byte Pair Encoding)、WordPiece、SentencePiece などの手法が使われます。たとえばBPEは、まず文字を1つずつの状態から始め、訓練データの中で頻繁に隣り合う組み合わせを繰り返し1つのトークンとして統合していく方法です。これらは細かな仕組みこそ異なりますが、「大量のテキストから、よく出てくる文字列のまとまりを見つけ、語彙として登録していく」という考え方は共通しています。
つまりサブワード分割は、単語単位の分かりやすさと、文字単位の柔軟さのあいだを取るための方法です。次の章では、この分割のされ方が、日本語と英語でどのように違って見えるのかを考えていきます。
4.日本語と英語でトークンの分かれ方はどう違うのか
トークン化の難しさは、言語によって少し変わります。特に、日本語と英語では、単語の境界が見えやすいかどうかに大きな違いがあります。
英語では、多くの場合、単語のあいだにスペースがあります。もちろん、英語でも複合語、略語、記号、固有名詞などの難しさはありますが、少なくとも「どこで単語が区切れていそうか」を見つける手がかりがあります。
一方、日本語には基本的に単語のあいだのスペースがありません。たとえば「機械学習を勉強する」という文を見たとき、人間は自然に「機械学習」「を」「勉強する」のようなまとまりを感じ取れます。しかし、トークナイザーにとっては、どの文字列を1つのまとまりとして扱うかを別の方法で決める必要があります。
さらに日本語では、ひらがな、カタカナ、漢字、英数字、記号が1つの文の中に混ざります。たとえば「AIでトークン数を確認する」のような文では、英字の AI、カタカナの トークン、漢字の 確認、ひらがなの助詞が同時に出てきます。この混ざり方も、トークン化を難しくする要因です。
実際、同じくらい短い文でも、日本語と英語でトークン数が変わることがあります。たとえば、あるトークナイザーでは次のようになります。
AIは文章をトークンに分けます。 → 12トークン
AI splits text into tokens.   → 6トークン
これは「日本語は必ず不利」という意味ではありません。トークン数は、使うトークナイザー、学習に使われたテキスト、語彙表の作り方によって変わります。ただ、日本語に十分対応していないトークナイザーでは、文字単位に近い細かい分割が増え、同じ内容でもトークン数が多くなることがあります。
このように、トークンの分かれ方は言語によって変わります。そして、この分割の差は「日本語の方が少しトークン数が多い」という見た目の問題にとどまりません。トークン列の長さはモデルが学習・推論する際の効率にも関わっています。次の章では、トークナイザーの設計の違いがモデル全体にどのような影響をもたらすのかを見ていきます。
5.トークナイザーの違いがモデルの性能に与える影響
トークナイザーはモデルの入口にある仕組みなので、分割のされ方は学習時にも推論時にも影響します。もちろん、モデルの性能はトークナイザーだけで決まるわけではありません。学習データ、モデルサイズ、学習方法なども大きく関係します。
なぜトークナイザーの分割がモデルの学習に影響するのでしょうか。その答えの一つは、埋め込み表の仕組みにあります。モデル内部では、各トークンに1つのベクトルが対応しています。つまり「1トークン = 1つの意味表現を学ぶ機会」です。たとえば「機械学習」が1トークンとして登録されていれば、そのベクトルがこの概念全体の意味を直接エンコードできます。一方、機・械・学・習という4つのトークンに分かれると、モデルはアテンション機構を通じてこれら4つの断片から概念を合成しなければなりません。これは単純に難しい学習タスクであり、同じ概念を正しく捉えるにはより多くの訓練データが必要になります。
Rust らの研究(2021年)では、多言語モデルにおいて1単語あたりのトークン数が高い言語ほど、下流タスクの性能が低くなる傾向が実証されています。これは、トークナイザーの設計がモデルの言語能力に直接関わることを示しています。
トークン数の多さは、推論時にも効いてきます。モデルが一度に扱えるトークン数(コンテキスト長)は固定されているため、日本語が英語の2倍のトークンを必要とするなら、同じコンテキスト窓に入る日本語の内容量は実質半分です。この影響は、長い文書を扱うときや多くの会話履歴を保持したいときに特に現れます。
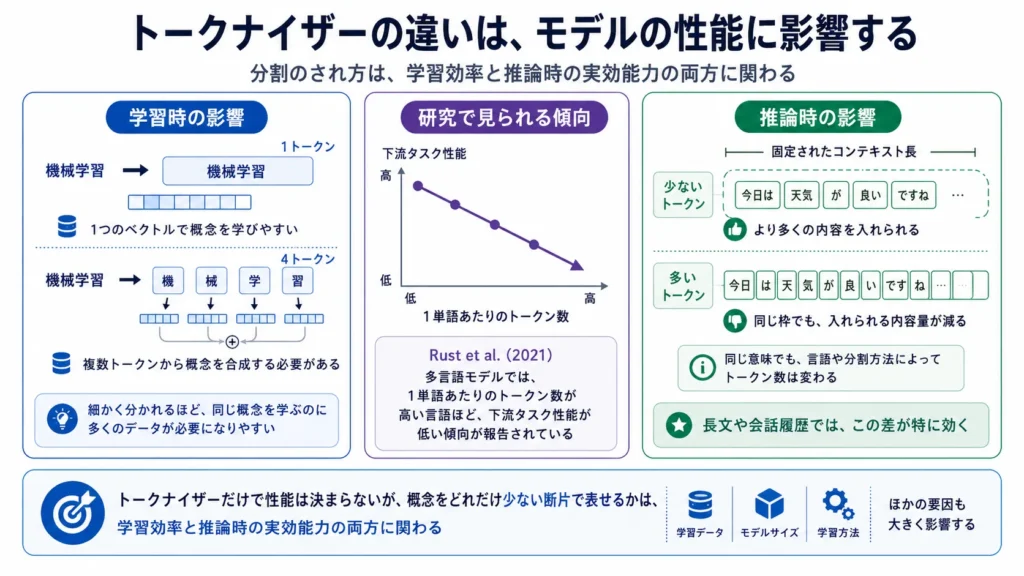
つまり、トークナイザーはモデルの「賢さ」を単独で決める部品ではありません。それでも、概念をどれだけ少ない断片で表せるかは、学習の効率と推論時の実効的な能力の両方に関わります。
まとめ
この記事で扱った内容を整理します。
- LLMは文章をそのまま読まない: 入力はトークンに分割され、トークンID → 埋め込みベクトルへと変換されてからモデルに渡される
- トークンは単語ではない: 多くのトークナイザーでは「サブワード」という単位が使われ、単語単位の分かりやすさと文字単位の柔軟さのバランスをとっている
- 言語によって分かれ方が違う: 日本語は英語と比べてトークン数が増えやすいことがあり、この差は推論時のコンテキスト効率に関わる
- トークナイザーの違いは性能にも影響する: 文章がどれだけ細かいトークンに分かれるかは、学習時の効率や、推論時に実質的に扱える情報量に影響する。ただし、モデルの性能はトークナイザーだけで決まるわけではなく、学習データ、モデルサイズ、学習方法なども大きく関係する
トークンは目立つ概念ではありませんが、LLMが文章を受け取り、モデルが扱える形へ変換するうえで欠かせない基本単位です。トークンの分かれ方を理解すると、LLMの入力上限、長文処理、日本語の扱い、そしてモデルの性能を考えるうえでの見通しがよくなります。