
*この記事は「さくらのAI検定( https://www.sakura.ad.jp/ai-certification/ )」教材として作成しています。
ここでは、さくらのAI EngineにおけるマルチモーダルAPIを実際に利用しながら、
テキストと画像を組み合わせた入力方法や、マルチモーダルAPIの基本的な使い方を学びます。
対応するマルチモーダルモデルの特徴を理解し、シンプルなチャットから画像認識までの具体的なAPI呼び出し例を通して、さくらのAI EngineのマルチモーダルAPIを実装レベルで扱えるようになることを目標とします。
マルチモーダルAPIを使った画像認識
ここでは、さくらのAI Engineが提供するマルチモーダルAPIを、実際のAPI呼び出しを通して確認していきます。
マルチモーダル対応モデルの一つであるQwen3-VL-30B-A3B-Instructを用い、まずはテキストのみのシンプルなチャットを行い、その後、画像URLやローカル画像を入力として与えた場合の挙動を順に試します。
APIの利用方法や入力形式を段階的に確認することで、マルチモーダルAPIの基本的な使い方を理解することを目的とします。
Qwen3-VL-30B-A3B-Instructを用いたシンプルなチャット
まずは、マルチモーダルモデルをテキストのみで利用し、通常のチャットとしてどのような応答が返ってくるのかを確認します。
ここで利用するAPIはchat completionと呼ばれるものです。
ターミナルまたはコマンドプロンプトを起動し、アカウントトークンを環境変数に設定します。
export AI_ENGINE_TOKEN="<発行したアカウントトークン>"(アカウントトークンが未発行の場合は、さくらのクラウドマニュアルを参考にして発行してください。)
今回実行するcurlコマンドでは、JSONを見やすく表示するためにjqを使用します。
jqがインストールされていない場合は、Ubuntu環境では次のコマンドでインストールできます。
(※ jqはJSONを整形・抽出するための補助ツールです。APIの動作自体には必須ではありませんので任意でインストールしてください。)
sudo apt install jqcurlコマンドを使って、API(Chat Completions)にリクエストを送り、AIからの応答を取得します。
ここでは、事前に設定した環境変数AI_ENGINE_TOKENを使って認証し、
「あなたはだれですか?」という質問をAIモデルに送信します。
curl -X POST "https://api.ai.sakura.ad.jp/v1/chat/completions" \
  -H "Authorization: Bearer ${AI_ENGINE_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "preview/Qwen3-VL-30B-A3B-Instruct",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "こんにちは"
          }
        ]
      }
    ],
    "temperature": 0.7,
    "max_tokens": 1000,
    "stream": false
  }' | jq
このcurlコマンドの主な意味は以下の通りです。
- APIエンドポイント
- v1/chat/completionsは、チャット形式でAIと対話するためのAPI
- 認証ヘッダー
- Authorization: Bearer ${AI_ENGINE_TOKEN}
- 環境変数に設定したトークンを使って認証
- 生成設定
- temperature:応答のばらつきを調整
- max_tokens:生成される最大トークン数を指定
- stream:今回は一括で応答を受け取る
実行すると以下のようなレスポンスが返ってきます。
{
  "id": "chatcmpl-f629d29ddc9c4012a414151ecf64aabe",
  "object": "chat.completion",
  "created": 1784954118,
  "model": "preview/Qwen3-VL-30B-A3B-Instruct",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "こんにちは!どうすればお手伝いできますか?",
        "refusal": null,
        "annotations": null,
        "audio": null,
        "function_call": null,
        "tool_calls": [],
        "reasoning_content": null
      },
      "logprobs": null,
      "finish_reason": "stop",
      "stop_reason": null,
      "token_ids": null
    }
  ],
  "service_tier": null,
  "system_fingerprint": null,
  "usage": {
    "prompt_tokens": 9,
    "total_tokens": 21,
    "completion_tokens": 12,
    "prompt_tokens_details": null
  },
  "prompt_logprobs": null,
  "prompt_token_ids": null,
  "kv_transfer_params": null
}
contentに質問に対する回答が書かれているのが確認できます。
他に確認しておきたい箇所は以下の通りです。
- finish_reason”: “stop”
- モデルが応答生成を終了した理由を示す値。”stop”は、モデルが自然に回答を完了した場合に返される。
- usage(利用量情報)
- prompt_tokens:入力(メッセージ類)のトークン数
- completion_tokens:今回の応答で生成されたトークン数
- total_tokens:合計消費トークン数(課金や利用量の目安)
テキストと画像を組み合わせたマルチモーダル入力
ここからは、このモデルの特徴であるマルチモーダル入力を実際に試していきます。
マルチモーダルとは、テキストだけでなく、画像や音声など複数の形式(モダリティ)を同時に扱えることを指します。
さくらのAI EngineのChat Completions APIでは、1つのメッセージの中にテキストと画像をまとめて渡すことで、画像を含めた対話が可能になります。
Chat Completions APIでは、messages[].contentを配列として指定できます。
これにより、以下のような入力構造を作ることができます。
- テキストによる指示(質問・依頼)
- 画像URLによる画像データの指定
人間で言えば、「この画像を見て説明して」と言いながら、画像を見せている状態に相当します。
それでは、実際に画像を含むリクエストを送信します。
今回は、画像について説明してもらうシンプルな指示を与えます。
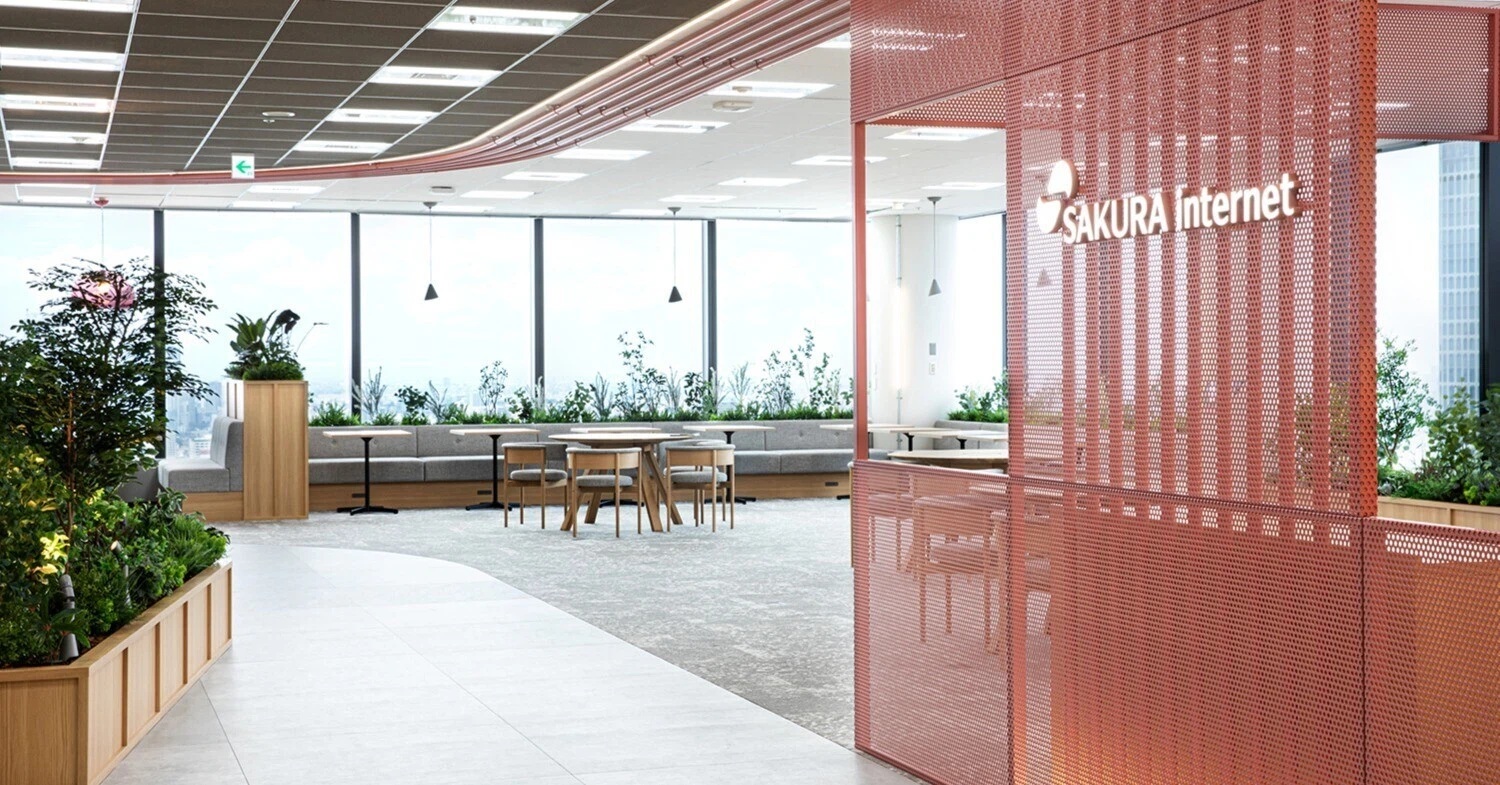
画像は下記URL(さくらのクラウドのオブジェクトストレージ)に格納されているファイルを使用します。
https://s3.tky01.sakurastorage.jp/ai-kentei/sakura-office.jpg
curl -X POST "https://api.ai.sakura.ad.jp/v1/chat/completions" \
  -H "Authorization: Bearer ${AI_ENGINE_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "preview/Qwen3-VL-30B-A3B-Instruct",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "この画像について説明してください。"
          },
          {
            "type": "image_url",
            "image_url": {
              "url": "https://s3.tky01.sakurastorage.jp/ai-kentei/sakura-office.jpg"
            }
          }
        ]
      }
    ],
    "temperature": 0.7,
    "max_tokens": 2000,
    "stream": false
  }' |jq
画像はさくらインターネット東京支社の写真です。
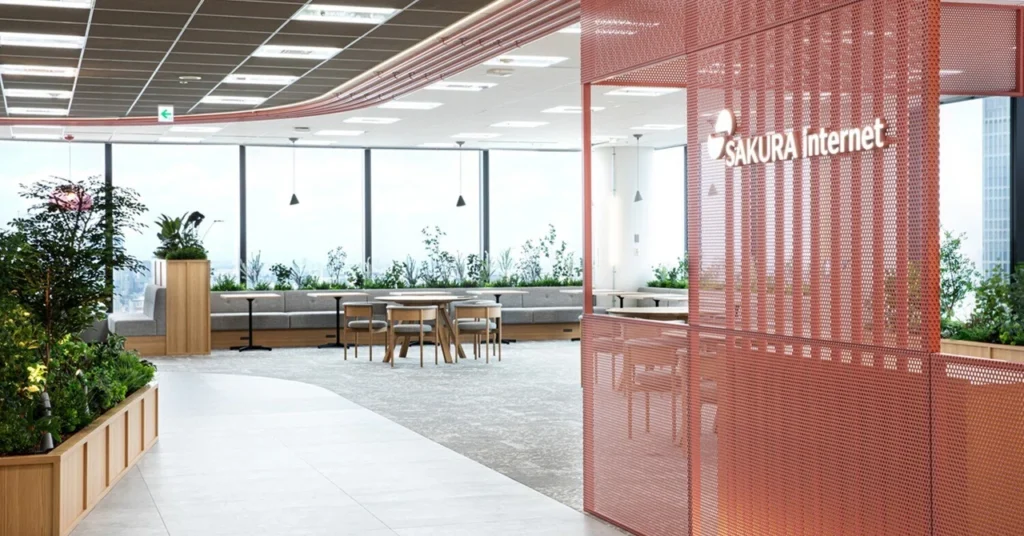
以下のようなレスポンスが返ってきます。
{
  "id": "chatcmpl-f607f8fc3c634a48801bb648bfcf0977",
  "object": "chat.completion",
  "created": 1784958025,
  "model": "preview/Qwen3-VL-30B-A3B-Instruct",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "この画像は、日本のインターネットサービスプロバイダー「さくらインターネット」のオフィスの内部を示しています。明るく開放的な空間で、現代的なデザインが特徴です。\n\n以下に詳細を説明します:\n\n- **ロゴとブランド**: 画像の右側には、オレンジ色のメッシュパネルに「SAKURA Internet」というロゴが大きく表示されています。これは、同社の企業イメージを強調するためのデザイン要素です。\n- **空間の構成**: フォーカスは、広々とした共用スペース(ラウンジや休憩エリア)です。床は明るい色のタイルで、天井は照明が組み込まれたモジュール式のもので、全体的に清潔感があります。\n- **家具と設備**: グレーのソファと木製のテーブル、椅子が配置されており、社員の休憩や会議に適した環境が整っています。背景には、大きな窓があり、外の都市の景色が見えます。\n- **緑の要素**: 空間には多くの植物が取り入れられており、左側には大きな木製のプランターに植えられた観葉植物、窓際にも緑の植栽が並んでいます。これにより、自然の要素が取り込まれ、リラックスできる雰囲気を醸し出しています。\n- **照明と天井**: 天井には、曲線的なデザインの配線や照明が施されており、機能性とデザイン性を兼ね備えています。また、天井の一部には緑色の矢印の案内標識も見えます。\n\n全体的に、このオフィスは社員の快適さと創造性を促進するための、洗練された空間設計がなされていることがわかります。",
        "refusal": null,
        "annotations": null,
        "audio": null,
        "function_call": null,
        "tool_calls": [],
        "reasoning_content": null
      },
      "logprobs": null,
      "finish_reason": "stop",
      "stop_reason": null,
      "token_ids": null
    }
  ],
  "service_tier": null,
  "system_fingerprint": null,
  "usage": {
    "prompt_tokens": 1193,
    "total_tokens": 1604,
    "completion_tokens": 411,
    "prompt_tokens_details": null
  },
  "prompt_logprobs": null,
  "prompt_token_ids": null,
  "kv_transfer_params": null
}
レスポンスの形式自体は、テキストのみのチャット時と同じ構造です。
違いは、モデルが画像を理解したうえで、テキストとして説明を返してくる点にあります。
このように、APIの使い方は大きく変更せずに、入力に画像を追加するだけで画像認識が可能になるのがマルチモーダルAPIの大きな利点です。
この仕組みを応用すると、次のような用途が考えられます。
- 画像の内容説明やキャプション生成
- スクリーンショットや図の要約
- 画像を含む問い合わせ対応の自動化
- 業務システムへの組み込み(チェック・補助判断など)
画像を直接埋め込むマルチモーダルAPIの画像認識
これまでの例では、画像をURL形式で指定、APIにリクエストする方法を見てきました。
この方法はシンプルで扱いやすい一方、画像を外部公開できない場合や、ローカル環境のファイルをそのまま扱いたい場合には使えないことがあります。
そのような場合、画像をbase64形式に変換してリクエスト内に埋め込むという方法も利用できます。
base64とは、画像のようなバイナリデータを英数字だけの文字列に変換する形式で、JSONやテキスト通信の中でもデータが破損しない形式で扱うために使用できます。
この方法では、画像ファイルを事前にどこかへアップロードする必要がなく、ローカル環境に格納されている画像をそのままAPIに渡すことができます。
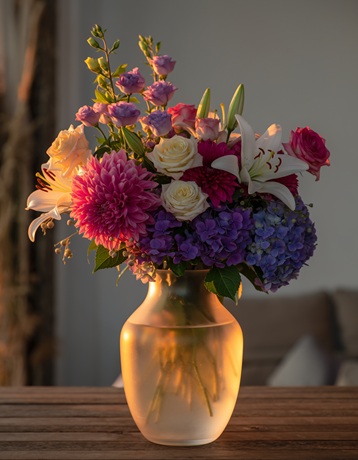
今回は下の画像を使用します。
画像をローカル環境にダウンロードし、「flower.jpg」というファイル名で保存してください。
(ダウンロードできない場合は、こちらのURLから画像をダウンロードしてください。)
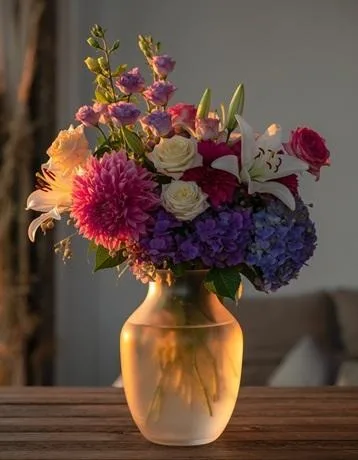
下記コマンドを実行します。こちらは、ローカルにある画像ファイルをbase64に変換し、そのままChat Completions APIに渡す例です。
curl -X POST "https://api.ai.sakura.ad.jp/v1/chat/completions" \
  -H "Authorization: Bearer ${AI_ENGINE_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "preview/Qwen3-VL-30B-A3B-Instruct",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "この画像について説明してください。"
          },
          {
            "type": "image_url",
            "image_url": {
              "url": "data:image/jpeg;base64,'$(base64 -w 0 flower.jpg)'"
            }
          }
        ]
      }
    ],
    "temperature": 0.7,
    "max_tokens": 2000,
    "stream": false
  }' \
| jq- “type”: “image_url”
- 画像を入力として扱うことを指定
- “url”: “data:image/jpeg;base64,…”
- base64形式の画像データを指定
- image/jpeg の部分は、画像形式に応じて変更する
- $(base64 -w 0 flower_45.jpg)
- ローカルの画像ファイルを base64形式に変換し、その結果を文字列として埋め込む
- -w 0 は、改行なしの1行で出力するための指定
成功した場合のレスポンス例はこちらです。
{
  "id": "chatcmpl-4c0eb5b68e5b4710b49aaa339b66bf05",
  "object": "chat.completion",
  "created": 1784960245,
  "model": "preview/Qwen3-VL-30B-A3B-Instruct",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "この画像は、木製のテーブルの上に置かれた花瓶に入った美しい花束を捉えています。花瓶は透明で、ややオーバルな形状をしており、中には水が入っているように見えます。花瓶の中には、ピンクのダリア、白いバラ、紫のカスミソウ、白いユリ、そして黄色やピンクの小花が混ざり合っており、色とりどりの花々が豊かに咲き誇っています。背景はややぼやけており、室内の落ち着いた雰囲気を醸し出しています。柔らかい光が花束を照らしており、温かみのある印象を与えています。全体的に、この画像は静けさと美しさを感じさせる、心和むシーンを描いています。",
        "refusal": null,
        "annotations": null,
        "audio": null,
        "function_call": null,
        "tool_calls": [],
        "reasoning_content": null
      },
      "logprobs": null,
      "finish_reason": "stop",
      "stop_reason": null,
      "token_ids": null
    }
  ],
  "service_tier": null,
  "system_fingerprint": null,
  "usage": {
    "prompt_tokens": 172,
    "total_tokens": 359,
    "completion_tokens": 187,
    "prompt_tokens_details": null
  },
  "prompt_logprobs": null,
  "prompt_token_ids": null,
  "kv_transfer_params": null
}
JSONファイル方式でのbase64画像処理
先ほど実施した、base64形式の画像をcurlコマンドに直接埋め込む方法は、手軽に試せる一方で、コマンド引数の長さ制限に引っかかりやすいという欠点があります。
具体的には、サンプル画像ではなく、自分で用意した画像を使用する場合、画像サイズが大きいことによる”Argument list too long”というエラーが発生することがあります。
(教材作成時の環境では、約120,000字を超えるとエラーが発生することを確認しています。)
エラーが出た場合は、まず次のコマンドでbase64形式に変換したあとの文字数を確認してください。
base64 -w 0 {ファイル名} | wc -cこのような制限を回避し、画像サイズを気にせず安定してマルチモーダルAPIを利用したい場合は、リクエスト内容をJSONファイルとして作成し、ファイルとして送信する方法があります。
この方法では、curlコマンド自体は短いまま、リクエストボディだけをファイル経由で渡すため、Argument list too long エラーを回避できます。
まず画像をbase64形式に変換してファイルに保存します。
(画像ファイル名はご自身で準備された画像ファイル名に書き換えてください。)
base64 -w 0 flower.jpg > flower.b64- -w 0 は、改行なしの1行で出力するための指定
- 生成されたflower.b64には、base64文字列のみが保存される
次に、Chat Completions API に送信するリクエストをJSONファイルとして作成します。下記を実行することでrequest.jsonファイルが作成されます。
cat > request.json <<EOF
{
  "model": "preview/Qwen3-VL-30B-A3B-Instruct",
  "messages": [
    {
      "role": "user",
      "content": [
        { "type": "text", "text": "この画像について説明してください。" },
        {
          "type": "image_url",
          "image_url": {
            "url": "data:image/jpeg;base64,$(cat flower.b64)"
          }
        }
      ]
    }
  ],
  "temperature": 0.7,
  "max_tokens": 2000,
  "stream": false
}
EOF- $(cat flower.b64) によって、base64文字列がJSON内に埋め込まれる
- 画像形式に応じて image/jpeg を image/png や image/webp に変更する
そして作成したrequest.jsonを指定して、APIを呼び出します。
curl -X POST "https://api.ai.sakura.ad.jp/v1/chat/completions" \
  -H "Authorization: Bearer ${AI_ENGINE_TOKEN}" \
  -H "Content-Type: application/json" \
  --data-binary @request.json | jq
この方法では、base64文字列はcurlの引数ではなくJSONファイルの内容として送信されるため、画像サイズに関わらず安定して実行できます。
実行例:
{
  "id": "chatcmpl-d09b3f1662a84e01af30ecaf1220db20",
  "object": "chat.completion",
  "created": 1784960642,
  "model": "preview/Qwen3-VL-30B-A3B-Instruct",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "この画像は、温かみのある光に照らされた花瓶..(省略)..静けさと美しさを感じさせる一枚です。",
        "refusal": null,
        "annotations": null,
        "audio": null,
        "function_call": null,
        "tool_calls": [],
        "reasoning_content": null
      },
      "logprobs": null,
      "finish_reason": "stop",
      "stop_reason": null,
      "token_ids": null
    }
  ],
  "service_tier": null,
  "system_fingerprint": null,
  "usage": {
    "prompt_tokens": 172,
    "total_tokens": 345,
    "completion_tokens": 173,
    "prompt_tokens_details": null
  },
  "prompt_logprobs": null,
  "prompt_token_ids": null,
  "kv_transfer_params": null
}
このように、JSONファイル方式を使うことで、画像サイズやコマンド引数の制限を気にせず、安定してマルチモーダルAPIによる画像認識を実行できます。
まとめ
今回は、さくらのAI Engine のマルチモーダルモデルを利用することで、テキスト入力だけでなく、画像を含む入力をAPI経由で扱う方法を学習しました。
画像はURL形式だけでなく、base64形式として直接リクエストに含めることもでき、
ローカルにある画像をそのまま入力として利用することが可能です。
本ハンズオンでは画像入力を例に取り上げましたが、マルチモーダルモデルは、複数の情報形式を統合的に扱い、それらを踏まえた推論や応答生成を可能にするモデルです。
テキストに限らず、異なる種類の情報を組み合わせて処理できる点が、マルチモーダルモデルの特徴です。
さくらのAI検定について
「さくらのAI検定」は、AIに取り組む企業や AIの学びを深めたい学校の先生、次世代を担う学生など、広範囲に渡るAI人材育成のためにさくらインターネットが設立した検定です。本コースでは、まず AI をさまざまな場面で使いこなすための基本知識を学ぶ「AI基礎」を提供します。そのうえで、さくらインターネットが提供する AI サービスの構成を理解し、さらに多様なハンズオンを通じて AI を実践的に学べる内容となっています。
本教材は、体験と理論を段階的に紐づけ、AIサービスの仕組みと活用方法を体系的に学べる構成としています。
なお、本教材に掲載している内容は、教育目的でその利用方法を紹介するものであり、さくらインターネット株式会社が当該技術の権利を有するもの、または公式に提供・保証するものではありません。
さくらのAI検定「AI実践」 目次
さくらのAI Engine 実践
- さくらのAI Engine 利用開始の手順
- さくらのAI Engine 利用開始の手順
- Playgroundを使ったチャット
- Playgroundを使ったチャット
- ドキュメント連携とRAG
- RAGの概要
- Playgroundを使ったRAGの実行
- APIを使ったRAGの実行
- 音声文字起こしAPI実践
- 音声文字起こしAPIの概要
- 音声文字起こしAPIの実行
- 応用編1:長時間音声の文字起こし
- 応用編2:文字起こし結果のサマリー作成
- MCP構成設計
- MCPの概要
- MCPを使った外部ツール連携
- クライアントへのMCP Server組み込み
- マルチモーダルAPI実践
- マルチモーダルAPIの概要
- さくらのAI EngineにおけるマルチモーダルAPI
- マルチモーダルAPIを使った画像認識(本記事)
- さくらの AI Engine料金体系
- さくらのAI Engineにおけるコスト計算の概要
- さくらのAI Engineにおけるコスト設計のポイント
高火力DOK実践
- 高火力DOKの概要
- 高火力DOKの概要
- ノートブックによる画像生成
- ノートブックによる画像生成
- 音声合成
- OpenVoiceを使った音声合成実践
- Open WebUI実践
- Open WebUIを使ったLLM環境の構築
- タスクによる画像生成
- タスクによる画像生成
- LoRA(軽量追加学習)実践
- LoaRAを使った画像生成実践