
- 論文タイトル
- EmbodiedLab: Benchmarking Embodied Agents That Act to Know(知るために行動する身体性エージェントの評価)
- 著者・研究機関
- Hongcheng Gao、Zelin Zheng、Alex Zhou、Jay Zhuほか、計21名。HexaFuture Inc.、清華大学、シンガポール国立大学、北京大学。
- 公開日
- 2026年10月26日(arXiv v1の初回公開)
- 研究のポイント
- 未知の物理量を調べるための操作・観測・解析を一つの課題に統合。答えだけでなく、その試行で得た測定証拠と実験台の最終状態も評価する。
- 技術的な解説
- 5分野30実験、14種類の装置を備えるシミュレーション環境。基本操作のみのT0で最高成功率43.3%。支援レベルの比較から操作技能の効果を分析する。実機性能や未知実験への汎化を示す結果ではない。
- zero to one解説
- 従来のロボット操作評価と科学発見評価を接続する研究。機械学習の予測精度に加えて、必要な情報を自ら取得し、根拠を残して作業を完了する能力を学べる。
ロボットが実験手順を再現できても、未知の値を自分で調べられるとは限りません。反対に、言語モデルが物理法則を説明できても、レンズを動かし、計器を読み、その読み取りが妥当か確かめられるとは限りません。「調べるために動く」能力を、どう評価すればよいのでしょうか。
EmbodiedLabは、この問いを扱う研究です。エージェントには達成目標と装置を渡し、実験方法の選択を任せます。結果の数値だけでなく、測定の根拠と最後の実験台の状態も採点します。既存のロボティクス入門から一歩進み、AIが観測と行動を結び付ける際の難しさを見ていきます。
「動かす」と「知る」を同じループで評価する
一般的な操作ベンチマークでは、物を指定位置に置くなど、目標となる状態があらかじめ与えられます。一方、科学発見の評価では、入力条件を選ぶと正確な数値やテキストが返り、装置を物理的に扱う部分が省かれることがあります。EmbodiedLabは、その間をつなぎます。
たとえばレンズの焦点距離を求めるなら、式を知っているだけでは不十分です。レンズやスクリーンを動かし、像の状態を観測し、測定条件を選ぶ必要があります。操作の仕方が得られる情報を変え、その情報が次の操作を決めます。原論文のFigure 2は、この循環を示しています。
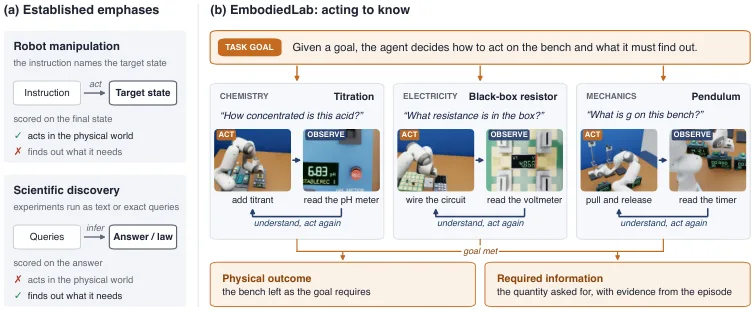
各インスタンスでは未知の物理パラメータを新たに抽選します。教科書の答えを記憶していても、その実験台の値は分かりません。目標は物性値の測定、応答の予測、指定条件を満たす装置設定のいずれかであり、手順そのものは指示されません。
正しい答えに加え、証拠と後片付けも必要
環境はIsaac Sim上のシミュレーションで、Franka Pandaアーム、二指グリッパー、3台のカメラを使います。力学・電気・光学・熱・化学の5分野に30実験があり、装置は14種類です。計器には量子化やノイズを入れ、目盛りや表示を読み取る必要を持たせています。実際の実験室で記録を出力する種類の計器だけが、ファイルを出力します。
成功判定には、数値誤差が許容範囲内であることに加えて、その試行中に得た計器の記録を引用していることや、測定条件が成立していることなどの条件があります。複数の量を答える場合は、各誤差をそれぞれの許容誤差で割り、その最大値が1以下かを判定します。どれか一つの量だけが正しくても成功にはなりません。
さらに、目標に必要な変更以外は元に戻します。答えが合っていても、器具を放置したままでは未完了です。これは単なる美観の問題ではありません。長い作業の中で何を変えたか追跡し、実験台を次に使える状態へ戻せるかも、評価したい能力だからです。
支援を増やすと、何が改善するのか
研究では、同じ実験を3段階のインターフェースで扱います。T0はカメラ画像、ロボット状態、関節位置の指令などの基本機能を提供します。知覚、軌道、把持方法などはエージェントが組み立てます。T1はセグメンテーション領域の真の深度を使う知覚と、衝突を避ける動作計画を追加します。T2は、強いエージェントの成功軌跡から作った把持・移動・押下などの技能を追加します。
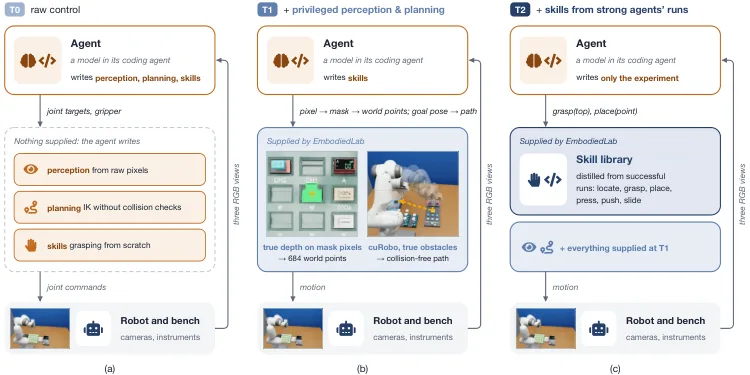
重要なのは、T2が診断用の条件である点です。同じ実験の成功例から技能を作るため、未知の実験への汎化を測る条件とはいえません。著者らも公開評価プロトコルからT2を外しています。支援の追加は「操作のどの部分が障害か」を調べる比較として読みます。
最高でもT0成功率43.3%――数値の読み方
6モデルを、それぞれ開発元のコーディングエージェントと組み合わせて評価しています。基本操作のT0ではClaude Opus 5.5が43.3%、GPT-6 Astraが40.0%、GPT-6.1 Solが28.3%でした。DeepSeek-V4.1-Flash-1017とKimi K3は各10.0%、GLM-5.3-Flashは0.0%です。これらは指定された環境・予算・ツール下でのシステムの成績であり、モデル単体の能力を切り離した順位ではありません。
T0からT1への成功率の改善は1.7〜10.0ポイントでした。対して、弱い側の3システムにT2の技能を追加すると、T1から10.0〜26.7ポイント改善します。たとえばDeepSeekはT1の13.3%からT2の40.0%へ上がりました。この条件では、知覚と計画の提供だけでなく、再利用できる操作技能が役立つことが分かります。
ただし、技能を渡しても実験の選び方や解析が自動的に解決するわけではありません。T2の効果を、そのまま汎用ロボットの性能向上や、別の実験室への適応性能と解釈することはできません。
付録の失敗分析から見える、最後まで完了する難しさ
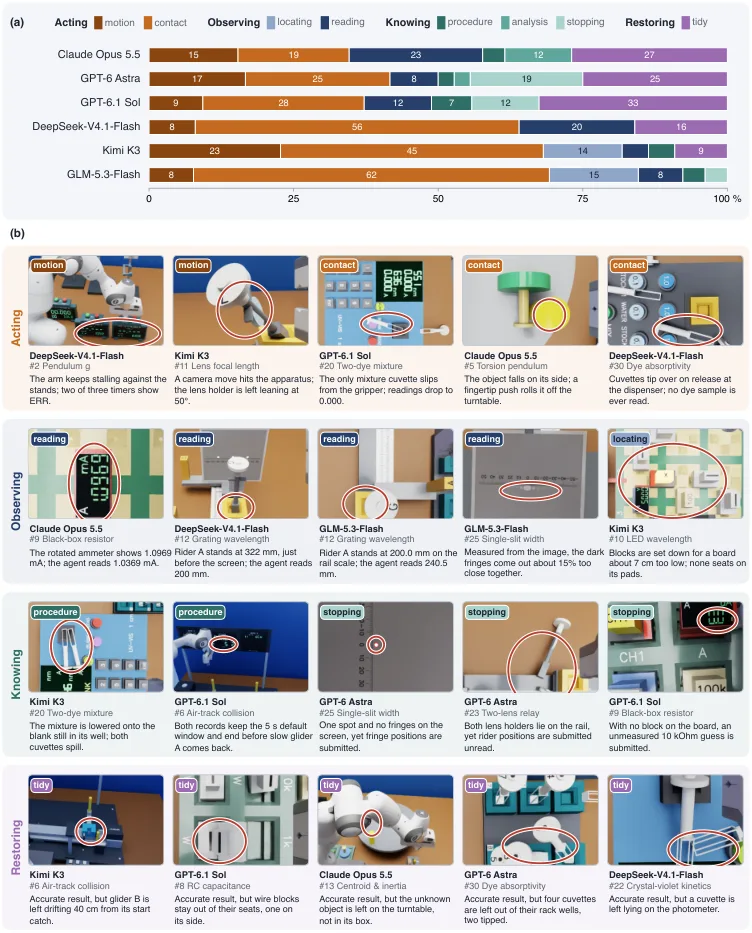
研究は、装置への操作開始、測定可能な状態、最初の有効な読み取り、十分な測定、正しい結果、実験台の復元という6段階で進捗を追います。強いシステムでも、解析や復元の段階で試行を落とします。GPT-6.1 Solでは、全試行の23%が、正しい結果を得た後に実験台を元に戻せていませんでした。
付録Figure 10は、失敗に至る最初の決定的な誤りを分類しています。エージェントごとに、操作・観測・復元を合わせた原因が75〜100%を占めます。ここでの分母は原因を特定できた失敗試行であり、全試行ではありません。物を取り落とす、表示を読み違える、器具を戻し忘れる、といった誤りが、科学知識とは別に実験を止めます。
エンジニアが持ち帰れる評価設計と限界
実装上の示唆は、最終回答と途中の証拠を一緒に検査することです。これは本記事としての解釈ですが、ツールを使うAIでも、正しい数値だけを見ると、無効な観測や未完了の操作を見逃すおそれがあります。測定記録を残し、最初に回復できなくなった段階を追う設計は、改善すべき箇所を具体化する助けになります。
一方、本論文はシミュレーションでの評価です。現実の装置、未知の摩擦や破損、実機のセンサー誤差への対応力まで示したわけではありません。対象は30実験に限られ、成績はエージェントの実装や時間予算にも依存します。EmbodiedLabの価値は、「知っているか」に加え、必要な情報を行動で得て、証拠を示して完了できるかを、一つの評価にまとめた点にあります。
原論文:EmbodiedLab: Benchmarking Embodied Agents That Act to Know(2026年10月26日公開)。実装:著者公開のGitHubリポジトリ。
本記事の制作について
本記事は、公開された研究論文をもとに、生成AIを活用して構成・執筆したものです。研究内容の正確な理解には、記事末尾に記載した原論文もあわせてご参照ください。