
こんにちは!
今回は、機械学習や深層学習でとても重要なパラメータである「学習率」について解説します!
「機械学習を始めたばかりで、学習率の設定に悩んでいる方」また、「学習率の基本的な考え方を知り、効果的な調整方法を学びたい方」に向けた記事となっております。
記事を読み終わる頃には、学習率に関する基礎知識と、最適な学習率の調整方法が理解できていると思います。それでは本文どうぞ!
1. 学習率とは?
学習率は、機械学習や深層学習における最適化プロセスにおいて、非常に重要なハイパーパラメータ(学習の過程で自動的に求められない値)です。学習率はモデルのパラメータ(例えば重み)の更新幅を決める役割を担っています。この更新量が適切でないと、モデルの学習がうまくいかなくなります。
学習率が高すぎると、損失関数の最適解を通り越してしまい、学習が発散する恐れがあります。一方で、学習率が低すぎると、更新が小さくなりすぎて学習に時間がかかり、効率が悪くなります。

これらの問題をより深く理解するために、モデルのパラメータを更新する際の数式を見てみましょう。以下の式では、勾配降下法と呼ばれる最適化手法を用いて、パラメータを更新しています。
・\(\theta_t\) :時刻tにおけるパラメータ(重み)
・\(\eta\) :学習率
・\(\nabla J(\theta_t)\) :損失関数 \(J(\theta_t)\) の勾配
勾配降下法では、損失関数 \(J(\theta_t)\) の勾配と学習率 \(\eta\) の積を元のパラメータから減算することで、パラメータを更新します。
ここで、学習率 \(\eta\) が適切に設定されていないと、モデルがうまく収束せず、最適解に到達することが難しくなります。
そのため今回は、学習率をどのように設定し、調整すれば効率的で安定した学習を実現できるのか、その手法について解説していきます。
2. 初期学習率の設定方法
初期学習率は、トレーニングの初期段階でのパラメータの更新速度を決めるため、非常に重要です。
一般的に使用される初期学習率の値としては、0.1, 0.01, 0.001 などが挙げられます。
これらの値は一つの目安であり、最適な値はモデルの種類やデータセットによって異なるため、最適な初期値を探索する方法をいくつか紹介したいと思います。
グリッドサーチとランダムサーチ
初期学習率の最適な値を見つけるために、「グリッドサーチ」や「ランダムサーチ」といった探索手法がよく使われます。
グリッドサーチは、あらかじめ決めた複数の学習率の候補(たとえば 0.1、0.01、0.001 など)をすべて試して、最も良い結果を出したものを選ぶ方法です。
一方で、ランダムサーチは、決められた範囲内からランダムに学習率を選んで試す方法です。すべてを試すわけではないため、効率的に良い値を見つけやすいのが特徴です。
どちらも「どの初期学習率が一番良いか」を客観的に判断するための手段であり、手動で調整するよりもずっと効果的です。
3. トレーニング中の学習率調整方法
初期学習率を設定した後、トレーニング中にその値を調整することは、学習を効率化するための重要なステップです。主要な調整方法は以下の2つです。
- 学習率スケジューリング
- 学習率ウォームアップ
これらの手法を活用することで、トレーニングの進行に応じた柔軟な学習率制御が可能となり、より効果的なモデル学習が実現できます。
学習率スケジューリング
学習率スケジューリングとは、トレーニングの進行に応じて学習率を段階的に変更する手法です。初期段階では大きな学習率で効率的に探索を行い、後半では小さな学習率で精度良く収束を図ります。主な手法は以下のとおりです。
- ステップ減衰:
一定のエポックごとに学習率を半分にする、または設定した比率で減少させる方法です。これにより、モデルの収束が進むにつれて学習率を調整し、最適解に近づけることができます。
- 指数減衰(Exponential Decay):
時間経過に伴い、学習率を指数関数的に減少させる方法です。この方法は、初期段階では大きな学習率で学習し、後半で急速に学習率を小さくすることができます。
- 余弦アニーリング(Cosine Annealing):
学習率を余弦波のように減少させる方法です。学習が進むにつれて学習率を滑らかに調整し、最適な解に収束する手助けをします。特に、最終的に学習率が非常に小さくなるため、収束時の安定性が増します。
これらのスケジューリング方法を選択することで、学習の過程で効率的に学習率を管理し、過学習を防ぎながら最適な解を見つけることができます。
学習率のウォームアップ
学習率ウォームアップは、トレーニングの初期段階で学習率を徐々に増加させる手法です。この方法は、急激に高い学習率でスタートすることによる学習の不安定さを避け、モデルの収束を安定させるために役立ちます。ウォームアップ期間中に学習率が徐々に増加し、その後、通常の学習率スケジューリングに従って学習が進行します。
ウォームアップは特にディープラーニングモデル(特に大規模なモデル)で効果的で、トレーニングの最初の段階で過大な勾配更新を防ぐためによく使われます。
4. Pythonで学習率を調整してみよう
このセクションでは、Pythonを使用して学習率を調整し、学習過程やモデルの性能に与える影響を比較していきます。
Scikit-learnを使った線形回帰モデルにおける学習率の設定
まず、簡単な線形回帰モデルを使用して、学習率の影響を確認します。ここでは、Scikit-learnの SGDRegressor(確率的勾配降下法を使った回帰モデル)を使用し、学習率の設定を行います。
今回は、一度大きすぎる学習率で試してみます。
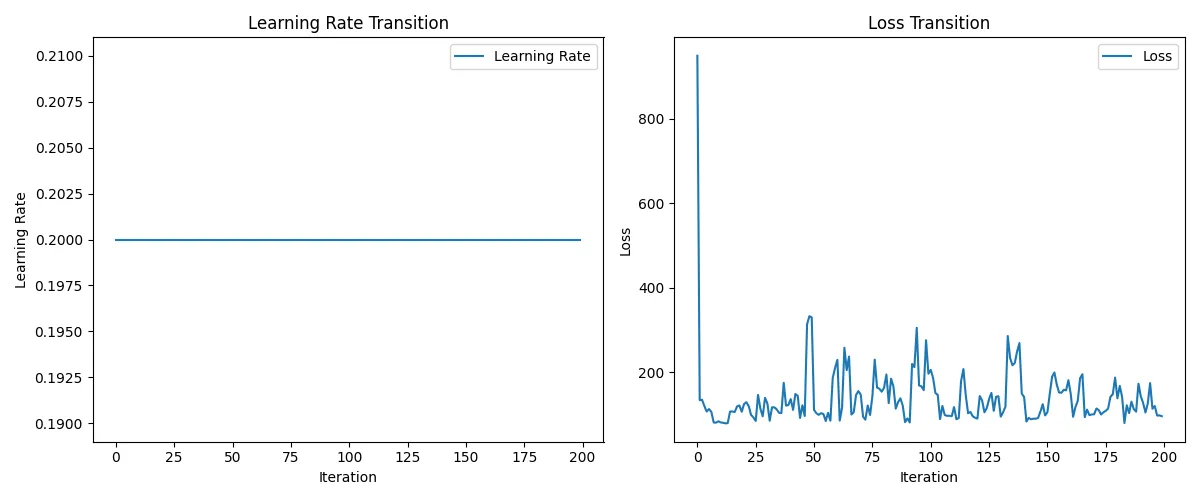
このコードでは、SGDRegressorを使い、学習率を更新しない(learning_rate='constant')設定で、初期学習率 initial_lr=0.2 を使って、トレーニングを行い、最適な重みを求めています。
結果の図を見るとLossが、最後まで収束できていないことがわかります。
では、次に、初期学習率を0.2にしたまま、トレーニング中に学習率を減衰させる学習率スケジューリングを導入するとLossがどう変化するのかを見ていきましょう。
学習率スケジューリング:学習率を指数的に減衰させる指数減衰の実装
学習率スケジューリングを使うことで、トレーニング中に学習率を段階的に減少させることができます。以下は、学習率をエポックごとに減衰させる方法を実装しており、初期学習率は大きめの値であるinitial_lr=0.2から始めています。Lossは収束するのか確認していきましょう。
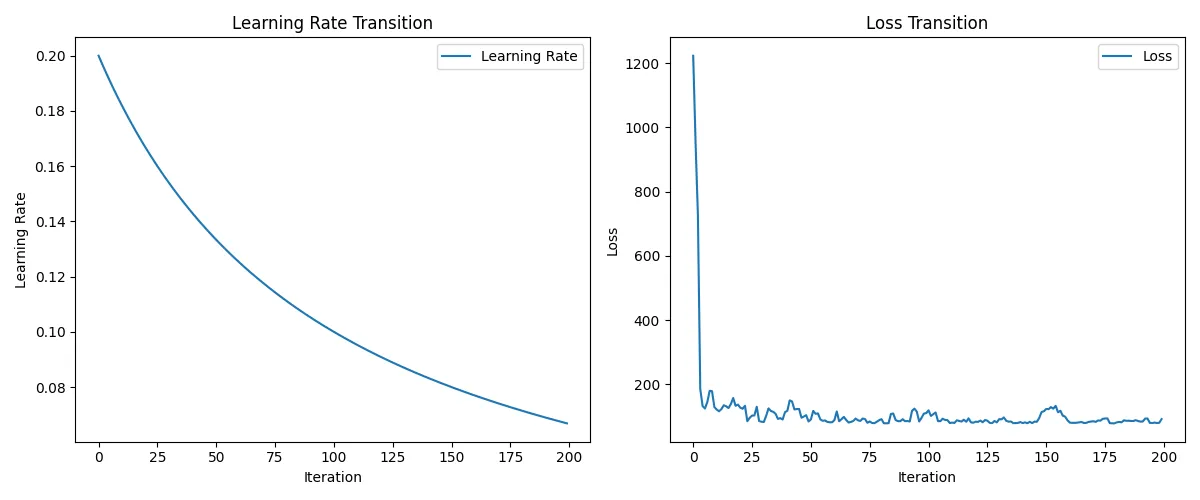
結果の図を見るとLossが収束していることがわかります。
このコードでは、lr = initial_lr / (1 + decay_rate * iteration) の部分で、イテレーション(学習回数)が進むにつれて、学習率を減衰させています。これにより、収束が安定する効果があります。
初期学習率が大きすぎてしまっても、トレーニング中に段階的に減衰させていくことで、収束を安定させることができる学習率スケジューリングは、非常に効果的な学習率の調整方法だということがわかりましたね。
5. まとめ
適切な学習率の設定と動的調整は、モデルの学習を効率化し、精度向上を図るうえで非常に重要です。
ぜひ本記事を参考に、実際のプロジェクトで最適な学習率の設定方法を試してみてください!