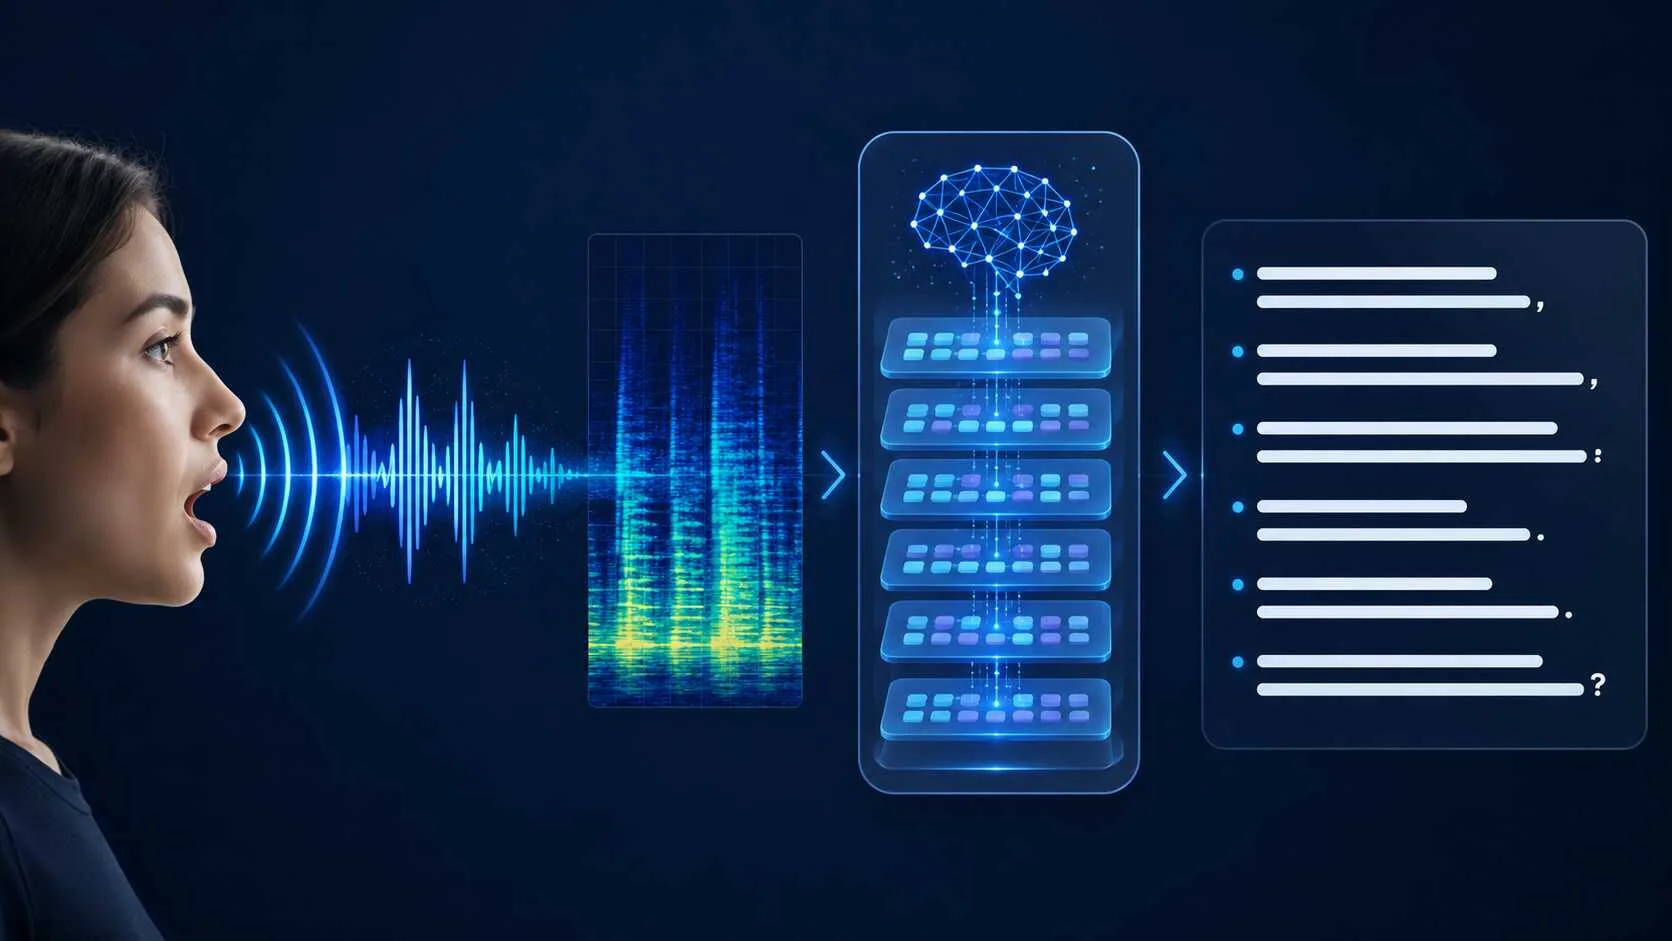

この記事で主に想定するのは、ChatGPT VoiceのLiveのように、マイクで話しかけ、AIの音声を聞きながら連続して会話する機能です。Liveでは、AIが話している間にもユーザーが話し、割り込むことができます。(ChatGPT Voice)本記事では、このような機能の特定サービスにおける内部構造ではなく、共通する技術的な課題を扱います。
このようなAIとの対話機能を使う場面では、返答の内容に加えて、返答を始める速さや、ユーザーの発話に合わせた振る舞いも、対話の円滑さを左右します。たとえば、ユーザーが話している間はAIが応答を待ち、AIが話している途中で「少し待ってください」と伝えられたときは、その発話を受け取ってAIが止まれる必要があります。比較のために、ユーザーが話し終えてからAIが返答する、ターン単位の音声対話も扱います。
本記事では、返答を早く始めるためのストリーミングと、Full-duplex対話を区別しながら、リアルタイム音声対話の仕組みを解説します。Full-duplex対話とは、ユーザーとAIが同時に音声を入力・出力できる対話方式です。ユーザーが話し終えてからAIが応答することを前提とせず、発話の重なりや割り込みを扱います。
Speech-to-Speechモデルの基本的な入出力や音声表現については、別記事「音声を入力し、音声で返答するAIはどのように動くのか? Speech-to-Speechモデルの仕組みを解説」で扱っています。本記事ではその前提を短く確認し、音声を生成できるモデルが、会話のタイミングをどのように扱うかに焦点を当てます。
1.音声を生成できても自然な会話にならない理由
Speech-to-Speechモデルは、ユーザーの音声を受け取り、返答の内容と話し方を表す音声表現を生成し、返答音声として出力できます。ただし、この入出力の仕組みだけでは、AIがいつ返答を始めるべきか、AIがいつ発話を止めるべきかまでは決まりません。
たとえば、ユーザーが「来週の予定を確認したいのですが」と言った後に短い沈黙を置いたとします。この沈黙が発話の終わりなのか、それとも続く言葉を考えている途中なのかは、音声の内容だけから常に一意には決められません。短い沈黙の直後にAIが返答を始めると、ユーザーの発話を遮ることがあります。一方で、発話が終わったあとも長く待つと、返答内容が適切でも会話は滞ったように感じられます。
AIが話している場面にも、同じ問題があります。ユーザーが「待ってください」「その部分をもう一度説明してください」と割り込んだとき、AIはユーザーの音声を受け取り、自身の出力を止め、次の応答へ切り替える必要があります。AIが返答を一方向に出し終えるまで入力を受け付けない設計では、このような割り込みを扱いにくくなります。
リアルタイム音声対話では、二つの観点を分けて考えます。一つは、AIが返答を始めるまでの待ち時間である応答開始の遅延です。もう一つは、AIが聞き続けるか、話し始めるか、話すのを止めるかを選ぶ会話タイミングの制御です。前者は待ち時間の長さを、後者はその時点で取る行動が適切かどうかを扱います。
応答開始の遅延を小さくするための方法の一つが、ストリーミングです。ストリーミングでは、入力音声を短い区間ごとに受け取り、その時点までの情報で処理を進めます。出力音声も短い区間ごとに生成・再生するため、返答全体の処理が完了する前から、AIは音声を出し始められます。
一方、会話タイミングの制御では、AIがユーザーの発話の流れに応じて、聞く・話す・止めるという行動を選びます。返答を速く始められても、ユーザーがまだ話している途中で毎回応答してしまえば、自然な対話にはなりません。逆に、適切なタイミングを判断できても、返答の音声が出るまでに長く待たせれば、会話の流れは途切れます。
したがって、リアルタイム音声対話では、低遅延と会話タイミングの制御を別々の能力として考える必要があります。次章では、まずストリーミングが、応答開始までの時間をどのように短くするのかを見ていきます。
2.ストリーミングによる応答開始の高速化
音声を小さな単位で処理・出力する流れ
ユーザーが話し終えるまで音声全体を待ち、その後に処理と音声生成を始める方式では、入力の受け取り、返答の生成、音声の再生が順番に進みます。そのため、長い発話ほど、AIが最初の音を出すまでに待つ時間が増えます。
ストリーミングでは、入力音声を短い時間区間ごとに受け取り、区間が届くたびに処理を進めます。返答を出すと決まった後は、返答音声も短い区間ごとに生成して順に再生します。つまり、入力音声全体や返答音声全体を一度に完成させる必要はありません。
処理の流れは、次のようになります。入力音声の次の小区間を処理している間に、先に生成できた返答音声の小区間を再生できます。実際の重なり方は実装によって異なりますが、入力・処理・出力を完全に順番待ちにしないことがポイントです。
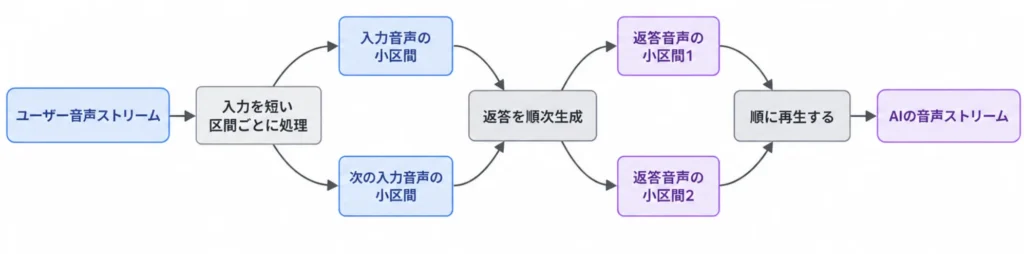
たとえば、返答が数文にわたる場合でも、最初の短い音声区間を生成できれば、残りを生成している間に再生を始められます。これは返答全体が終わるまでの時間を必ず短くするとは限りませんが、ユーザーが最初の音を聞くまでの時間を小さくする方法になります。
ただし、ストリーミングはAIがいつ返答すべきかを決める仕組みではありません。入力を早く処理できても、短い沈黙を発話終了と誤って判断すれば、AIは不適切なタイミングで話し始めます。この判断は、第3章で扱う会話タイミングの制御に属します。
音声区間とバッファの設計
ユーザーの音声を区間ごとに処理し、返答音声を順に再生する実装では、音声区間の大きさや、音声を一時的に保持するバッファの設計が関係します。入力を処理するときには直前の発話を参照する必要があり、出力を再生するときには次の音声区間が少し遅れても音が途切れないようにする必要があります。バッファとは、このような処理や再生に使うデータを短時間だけためておく領域です。
入力側では、音声区間が届くたびに、その区間と直前までの区間を使って、発話内容の処理を更新します。このとき過去の区間を残しておく入力バッファがあると、直前の発話の流れを参照できます。すべての入力を待つ必要はありませんが、保持する区間が短すぎると、必要な文脈を参照できないことがあります。
出力側では、実装によっては生成した短い音声区間を出力バッファにためてから再生します。生成した区間をただちに再生すると、次の区間の生成や通信が少し遅れただけで音が途切れる可能性があるためです。出力バッファはその揺らぎを吸収しますが、ためる量を増やすほど再生開始までの待ち時間も増えます。
このように、区間やバッファを小さくすれば待ち時間は減らせますが、入力の理解に必要な文脈や、出力音声の滑らかさを保ちにくくなります。ストリーミングでは、この両立が重要な設計課題です。
ストリーミングで待ち時間が短くなる理由
ストリーミングの効果は、返答に必要な時間をすべてなくすことではありません。ユーザーが話している間に入力の処理を進め、最初の返答音声区間を生成できた時点で再生を始められることにあります。返答を考える時間、最初の音声区間を生成する時間、通信や再生の準備にかかる時間は残ります。また、ユーザーが話し終えてから最初の音を聞くまでの待ち時間には、発話終了を判断する時間も加わります。
ストリーミングは待ち時間を減らすための重要な方式です。しかし、低遅延だけではリアルタイムな会話は成立しません。次章では、相手が話している間にも音声を受け取り、必要に応じて応答できるFull-duplex対話で、発話の開始と停止をどのように制御するかを説明します。
3.Full-duplex対話におけるTurn-takingの実現
第2章のストリーミングは、返答を早く出し始めるための方式でした。一方、Full-duplex対話で必要なのは、ユーザーとAIの音声が重なる可能性がある中で、次に何をするかを選ぶことです。Turn-takingとは、聞き続けるか、話し始めるか、話すのを止めるかといった、発話の交替に関わる行動を決める仕組みです。
Half-duplexとFull-duplexの違い
Half-duplex対話では、一方が話している間は、もう一方が返答を待つことを基本とします。ユーザーの発話を一つのターンとして受け取り、AIが返答を終えた後に、次のユーザーの発話を受け取ります。この方式は、どちらが話す番かを明確にしやすい一方、ユーザーがAIの発話に途中で補足や訂正を加えたい場面を扱いにくくします。
これに対してFull-duplex対話では、AIが話している間もユーザーの音声を受け取り続け、ユーザーの発話中にも必要に応じてAIが音声を出せます。常に二者が同時に話すという意味ではありません。重なった音声を受け取ったときに、AIが話し続けるのか、ユーザーへ話す番を譲るのかを選べることが重要です。
連続する二つの音声ストリーム
Full-duplex対話では、ユーザー側の入力とAI側の出力を、時間とともに更新される二つのストリームとして扱います。AIの出力中もユーザー側の入力処理を止めないため、ユーザーの「待ってください」のような発話を受け取り、次の判断に反映できます。
この機能を実現する内部構造には、少なくとも二つの設計があります。モジュールを組み合わせる方式では、ストリーミング音声認識がユーザー音声を少しずつテキストへ変換し、その結果を言語モデルへ渡します。言語モデルの出力は、ストリーミング音声合成へ順に渡されます。Wangらは、こうした入力経路と出力経路を並行して動かし、AIが話している間にも新しいユーザー入力を扱う構成を提案しています。Wang et al.
別の設計では、Speech-to-Speechモデルが、ユーザー音声とAI音声を時間同期した系列として直接扱います。Moshi は、二者の音声を別々の音声トークン系列として扱い、AI側の次の音声トークンを生成します。(音声トークンとは、音声をモデルが扱いやすい離散的な記号列へ変換したものです。)AIが話さない時間には、無音に対応するトークンを生成します。
両者は内部構造が異なります。前者では、音声認識、言語モデル、音声合成、状態制御が別々の部品になり得ます。後者では、それらに相当する処理の一部が一つのモデルに統合されます。ただし、AIが話している間もユーザーの入力を更新し、その時点のAI側の出力状態と合わせて次の行動を決める点は共通しています。
複数の手がかりから発話終了を推定する
Turn-takingは、無音を見つけるだけの処理ではありません。VAD(Voice Activity Detection)は、短い音声区間に人の声が含まれるかどうかを検出する部品です。無音を見つけることには役立ちますが、短い無音が発話終了を意味するとは限りません。考え中の間、フィラー、言い直し、語尾を伸ばす発話にも、無音や発話の弱まりが現れます。
そのため、研究では目的に応じて、現在の音声活動、無音の長さや時間パターン、韻律(声の高さや強さ、伸ばし方など)、発話内容、対話履歴、二者の発話の重なりなどを手がかりにします。すべての研究がこれらを一度に使うわけではありません。Changらは、音響情報と音声認識で得た言葉の履歴を組み合わせて、発話中・短い休止・発話終了を区別する方法を示しています。Chang et al.
また、VAP(Voice Activity Projection)という研究では、発話終了という一つのラベルだけでなく、対話者が今後どのように話すかという音声活動の時間パターンを予測します(Ekstedt and Skantze)。 これにより、短い無音のあとに同じ話者が続けるのか、相手が話し始めるのかを、固定した無音時間だけで決めない考え方が示されています。
判断に応じて聞く・話す・止める制御
Turn-takingの予測結果は、発話が終わったかどうかの判定だけで終わりません。AIは予測結果をもとに、聞き続ける、話し始める、話し続ける、話すのを止める、短く応答するといった次の行動を選びます。
Full-duplex対話では、とくに次の三つの場面で、この行動選択が重要になります。これらはTurn-takingのすべてを網羅する分類ではなく、AIが聞く・話す・待つを切り替える代表的な対話場面です。
- Barge-in : AIが話している最中にユーザーが発話を差し込む場面
- Backchanneling : ユーザーが話している間にAIが短い相づちを返す場面
- Pause handling : ユーザーの短い沈黙に対してAIが待つ場面
Barge-in(割り込みへの対応)は、AIが話している最中にユーザーが発話を差し込み、その発話にAIが対応する場面です。たとえば、AIが説明している途中にユーザーが短く「はい」と言った場合、AIはそれを相づちとして扱い、説明を続けることがあります。一方で、ユーザーが「待ってください」と発話した場合、AIは説明を止めて、ユーザーの発話を聞き取る状態へ切り替えます。ここで重要なのは、ユーザーの声を検出した瞬間に必ずAIの出力を止めるのではなく、発話内容、対話の流れ、AIが現在どこまで話しているかを考慮して、出力を続けるか止めるかを選ぶことです。
Backchanneling(相づち)は、AIがユーザーの発話中に、相手のターンを取らず「はい」「なるほど」のような短い応答を返す行動です。AIは短い相づちを返したあと、すぐに聞く状態へ戻る必要があります。そのため、返答を始める行動とは別に、相づちを返すタイミングと種類を選ぶ必要があります。相づちを返すタイミングと種類を連続的に予測する研究も報告されています(Inoue et al.)。
Pause handling(短い沈黙への対応)は、ユーザーの短い沈黙に対して、AIがすぐにターンを取らずに待つ行動です。短い沈黙は発話終了の場合もあれば、考え中、言い直し、次の言葉を探している途中の場合もあります。したがって、沈黙を検出しただけで話し始めるのではなく、沈黙の長さ、話し方、発話内容、対話履歴をもとに待つか話し始めるかを選びます。無音を検出したあとに何もしないことも、Turn-takingにおける判断結果の一つです。
このような行動選択を実際の処理へ変換する方法の一例が、Wangらのモジュール型の構成です。言語モデルは「聞き続ける」「返答を開始する」「出力を続ける」「出力を止めて聞く」という状態遷移を表す制御トークンを生成し、FSM(Finite State Machine)を動かします。
FSMは、取り得る状態をあらかじめ限られた個数で定め、現在の状態と受け取った入力に応じて次の状態を切り替える制御方法です。この例では、「聞いている」「話している」「出力を止めて聞く」といった状態を持ちます。たとえばAIが話している状態で「出力を止めて聞く」という制御トークンを受け取ると、音声出力を停止し、ユーザーの発話を受け取る状態へ移ります。FSMは、このように判断結果を再生や停止といった具体的な動作へ確実に反映する役割を持ちます。(Wang et al.)
こうした制御の流れを、各機能の担当を見分けられるように抽象化すると、次のようになります。これは実装上の部品構成ではなく、Full-duplex対話に必要な機能上の役割を示した図です。モジュール型ではこれらの処理が分かれている場合があり、Speech-to-Speechモデルでは複数の処理が一つのモデルに統合されている場合があります。
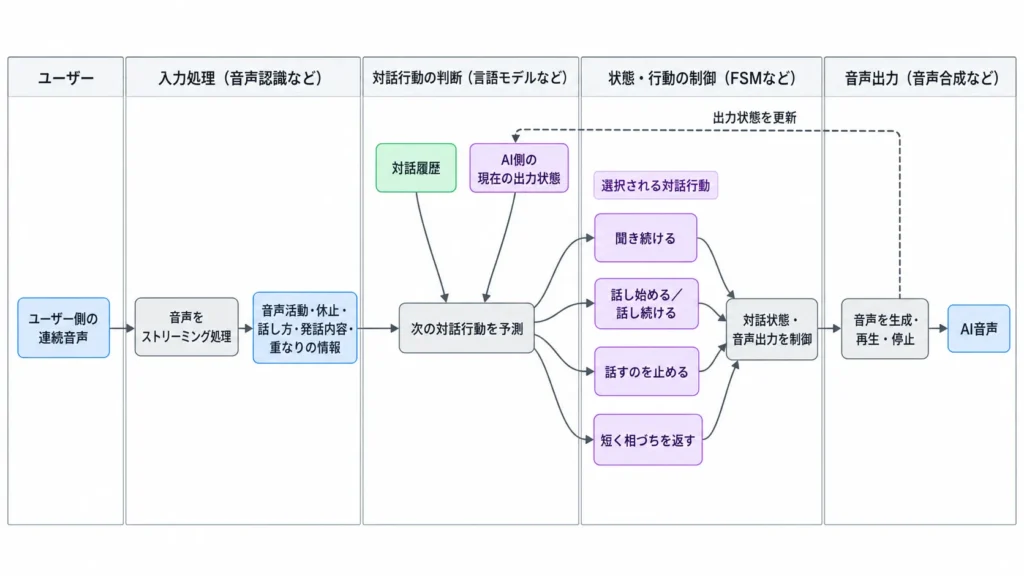
第2章のストリーミングは、返答を早く出し始めるための仕組みでした。第3章で見たTurn-takingは、その出力をいつ始め、いつ続け、いつ止めるかを決める仕組みです。低遅延の処理と会話タイミングの制御を組み合わせることで、応答の速さと会話に合った振る舞いを両立できます。
まとめ
リアルタイム音声対話では、音声で返答を生成できるだけでは十分ではありません。ユーザーの発話を待つべき場面と、返答を始めるべき場面、AI自身の発話を止めるべき場面を、対話の流れに応じて扱う必要があります。
- ストリーミングは、音声を短い区間ごとに処理・生成・再生することで、返答全体が完成する前に最初の音を出せるようにします。
- Full-duplex対話は、AIが話している間もユーザーの入力を受け取り、会話の重なりを扱えるようにする方式です。
- Turn-takingは、音声活動、休止、話し方、発話内容、対話文脈などをもとに、聞く・話す・止める・相づちを返すといった行動を選びます。
実際の内部構造は、音声認識・言語モデル・音声合成を組み合わせる方式と、音声の二つのストリームを直接扱うSpeech-to-Speech方式で異なります。それでも、AIが話している間も入力を更新し、次に取る行動を決めることが、自然な音声対話を実現する共通の要件です。