
強化学習について、これからシリーズ形式でまとめていきたいと思います。
このシリーズでは、AIや機械学習、深層学習について少し学び始めた人から、実際に技術として活用したい人、さらに研究で使っていきたい人までを対象に、基礎から段階的に説明していきます。
初回となる今回は、まず 「そもそも強化学習とは何なのか?」 について、できるだけ専門用語を使わず、わかりやすく紹介していきます。
導入:「強化学習」って何?
最近では、ChatGPTやClaudeなど生成AIの登場によって、「AI」や「機械学習」という言葉を耳にする機会がかなり増えてきました。AIが文章を書いたり、画像を作ったり、写真に写っているものを見分けたりと、さまざまなことができるようになっています。そんなAIの学習方法の一つに、「強化学習(Reinforcement Learning)」があります。
強化学習をものすごく簡単に言うと、
です。
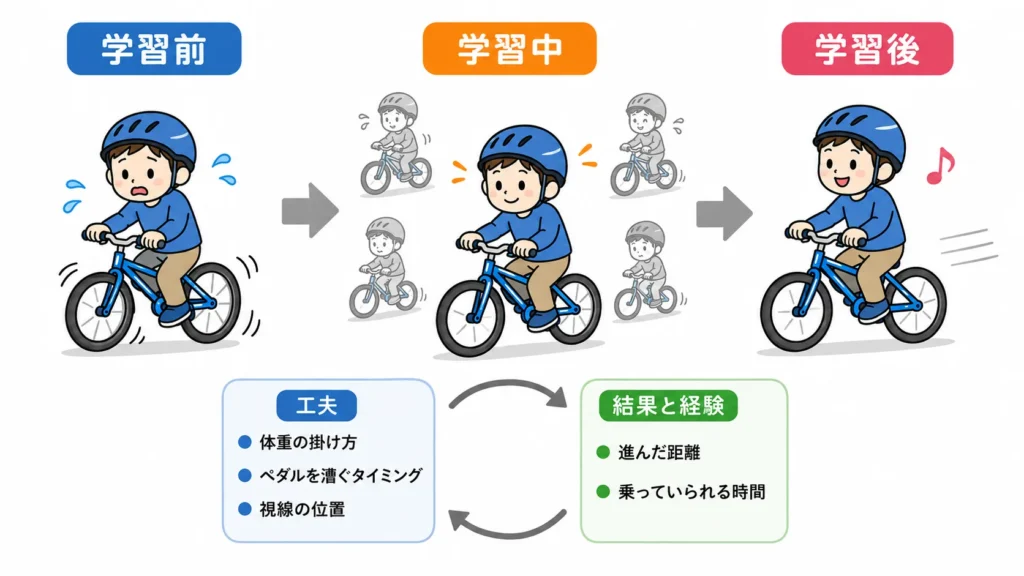
例えば、自転車に乗れるようになったときのことを思い出してみてください。
最初はうまくバランスを取れず、少し進んだだけで倒れそうになったり、実際に転んでしまったりしたと思います。それでも何度も練習するうちに、「もう少しゆっくりハンドルを動かそう」「体を少しこちら側に傾けよう」といった工夫を重ね、少しずつ長く走れるようになっていきます。
そして最終的には、バランスの取り方やペダルの漕ぎ方を身につけ、転ばずに自転車を走らせられるようになります。「どう行動すれば、よりうまく自転車を走らせられるのか」を少しずつ「学習」しているのです。
強化学習は、基本的にこれとおなじです。我々も日々強化学習しているということですね。
強化学習でできること・使われる場面
では、強化学習の技術はどのような場面で使われているでしょうか?
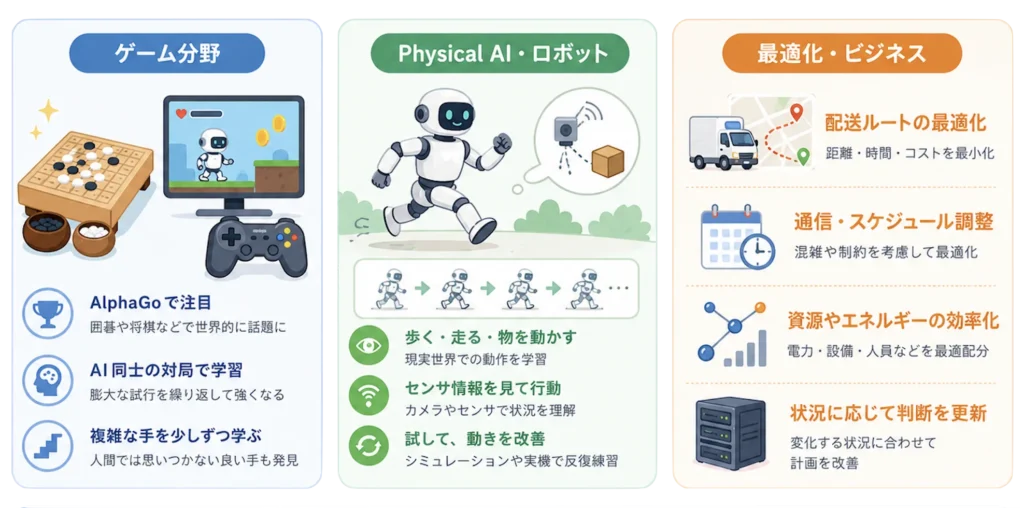
強化学習という言葉が広く知られるようになったきっかけの一つが、ゲーム分野での活躍です。その代表的な例として、囲碁AIのAlphaGoがあります。囲碁では、盤面の状況を見ながら「次にどこへ石を置くか」を判断しなければなりません。しかし、考えられる局面の数は非常に多く、すべてのパターンについて人間が正解を教えることは現実的ではありません。そこで、AI同士で何度も対局を行い、その勝敗や対局結果を学習に利用することで、より強い打ち方を身につけていきました。この頃は、現在のような社会実装そのものよりも、強化学習のアルゴリズムがどこまで複雑な問題を学習できるのかという点に大きな注目が集まっていた時期でもあります。
また、強化学習は、近年特に注目を集めているPhysical AI(フィジカルAI)の分野でも活用されています。Physical AIとは、簡単にいうと、AI技術とロボット技術を組み合わせ、現実世界で実際に動くAIを実現する技術です。近年では、人型ロボットの開発競争が世界各地で進んでおり、中国ではロボットによる陸上競技大会が開催されるなど、技術の進歩が目覚ましい分野でもあります。例えば、ロボットに「歩く」「走る」といった動作を覚えさせる場合、人間がすべての関節やモーターの動かし方を細かく指定するのは非常に大変です。そこで強化学習を使い、ロボット自身が実際に動いたり、シミュレーション上で何度も試したりしながら、センサから得られる情報や動作の結果をもとに、より良い動き方を学習していきます。まさに、人間が何度も転びながら自転車の乗り方を覚えたり、スポーツの動きを身につけたりするのと似たような考え方です。
そのほかにも、通信ネットワークの制御や配送ルートの決定、スケジュールの最適化など、さまざまな場面で強化学習の活用が進んでいます。例えば配送では、「どの荷物を、どの車で、どの順番に届けるか」を考える必要がありますが、交通状況や注文の追加などによって最適なルートは常に変化します。強化学習では、このように状況が変わる中で何度も判断を繰り返し、その結果をもとに、より効率のよい方法を学習していくことができます。工場の生産計画や人員配置、コンピュータ資源の割り当てなどにも同じ考え方を応用できます。つまり、選択肢が多く、人が毎回正解を決めるのが難しい問題に対して、試行錯誤を通じてより良い方法を探していけることが、強化学習の強みの一つです。
学習の方法、他のAI学習法とのちがい
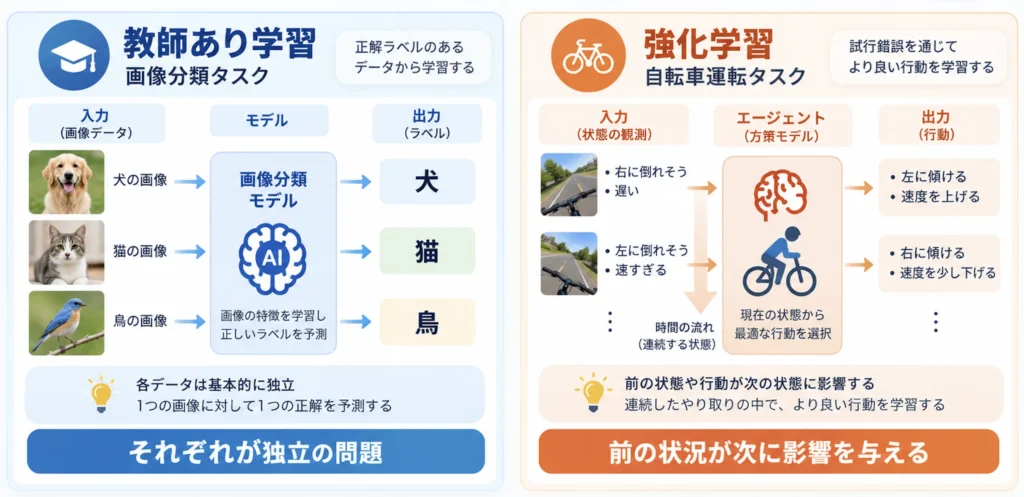
強化学習は通常の教師あり学習のような機械学習とどのようなところが違うのでしょうか。教師あり学習タスクとして画像分類と強化学習のタスクとして先ほどの自転車の運転の例をもちいて教師あり学習と強化学習の違いを見てみましょう。
問題設定の違い
まず、教師あり学習と強化学習では、問題の目的や設定が大きく異なります。画像分類タスクでは、1枚の画像を入力として、その画像に対応するラベルを出力します。各画像は基本的に独立しており、ある画像に対する予測結果が、次の画像の予測に影響することはありません。一方、自転車の運転では、現在の状況をもとに適切な行動を選択します。このとき、現在の行動は次の状態に影響し、その後の行動にもつながっていきます。また、「速く進みたい」「安全にゆっくり進みたい」といった将来の目標によっても、選ぶべき行動は変わります。そのため、強化学習は、各時刻の問題が独立しているのではなく、過去の行動から未来の結果までが時間的につながった問題として扱われます。
学習の仕方の違い
次に、学習の仕方も大きく異なります。教師あり学習では、あらかじめ「画像」と「正解ラベル」の組み合わせを大量に用意し、それらを使ってモデルを学習させます。たとえば、犬の画像には「犬」、猫の画像には「猫」という正解を与え、モデルが出した予測と正解とのずれが小さくなるように、モデル内部のパラメータを少しずつ調整していきます。つまり、教師あり学習では、あらかじめ用意された正解を手がかりに、入力と出力の関係を学習していくことが基本となります。
一方、強化学習では、最初から「この状況ではこの行動が正解」というデータが用意されているわけではありません。エージェントが実際に行動し、その結果として得られる報酬やペナルティ(行動した結果のスコアのようなもの)をもとに、どの行動が良かったのかを学習していきます。たとえば自転車の運転であれば、適切な速度で安定して走れた場合には高い報酬を与え、転倒したりスピード違反をしたりした場合には低い報酬を与えます。こうした試行錯誤を繰り返すことで、エージェントは「どのような状況で、どの行動を選べば、将来的により大きな報酬を得られるのか」を学習していきます。
強化学習の難しいところ
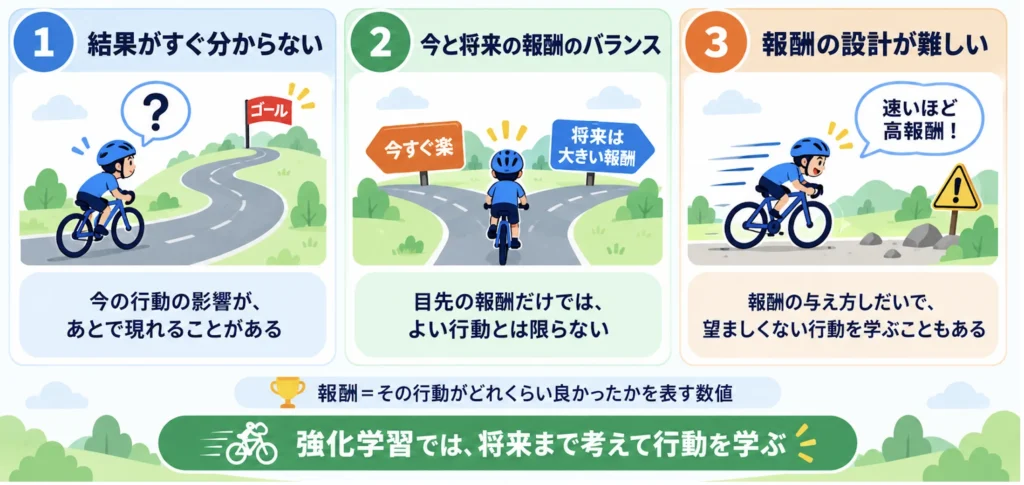
強化学習では、エージェントが行動した結果として得られる報酬を手がかりに学習します。報酬とは、「その行動がどれくらい良かったか」を数字で表したものです。たとえば、自転車を安全に運転できたらプラスの報酬、転んだらマイナスの報酬を与える、といった形です。
ただし、行動の良し悪しがすぐに分かるとは限りません。たとえば自転車で少し無理な操作をしても、その瞬間には問題が起きず、数秒後に転ぶかもしれません。そのため、「どの行動が最終的な結果に影響したのか」を考えながら学習する必要があります。
また、目先の報酬だけを大きくすればよいわけではありません。今すぐ高い報酬がもらえる行動でも、その後に悪い結果につながることがあります。反対に、一時的に失敗しても、新しい行動を試すことで、もっと良い方法を見つけられることもあります。強化学習では、今の報酬と将来の報酬の両方を考えることが重要です。
さらに難しいのが、報酬の設計です。エージェントは人間の目的をそのまま理解しているわけではなく、設定された報酬をできるだけ大きくしようとします。そのため、報酬の設定が悪いと、想定していない行動を学んでしまうことがあります。
たとえば自転車で「速く走るほど高い報酬」とすると、エージェントは安全性を無視して、「転ぶ可能性があっても全力で走る」ことを選ぶかもしれません。ゲームでも、本当はボスのクッパを倒すことが目的なのに、クリボーのような雑魚敵を倒すほうが多くの報酬をもらえる設定なら、エージェントはボスを無視して雑魚敵ばかり倒す可能性があります。
まとめ
今回は、強化学習について「そもそもどのような学習方法なのか」というところから、何に使われているのか、教師あり学習との違い、そして強化学習ならではの難しさまで紹介しました。
強化学習は、行動した結果として得られる報酬をもとに、試行錯誤しながらより良い行動を学ぶ方法です。教師あり学習のように正解を与えるのではなく、現在の行動が将来の結果にどうつながるかを考えながら学習します。また、どの行動を「良い」と評価するかを決める報酬の設計も重要です。強化学習は、自転車やスポーツのように、失敗を繰り返しながら少しずつ上達していく学習と考えるとイメージしやすいでしょう。
次回は、強化学習の仕組みをもう少し正確に理解するために、「状態」「行動」「報酬」「環境」といった具体的な用語、そして重要な要素であるマルコフ決定過程について説明します。