
Transformerはもともと文章のために生まれたアーキテクチャですが、いまでは画像認識の主役の一つでもあります。その立役者が、画像を小さなパッチ(断片)に分割し、文章の単語のように並べて処理する Vision Transformer(ViT) です。
ところが、画像をパッチに切り分けて並べると、ある情報がこぼれ落ちます。「そのパッチが、もともと画像のどこにあったか」という位置の情報です。
ViTは、この失われた位置をどう取り戻しているのでしょうか。本記事では、ViTが使う 位置エンコーディング(Positional Encoding) について、「パッチに番号を振るためのもの」という単純な見方にとどまらず、画像の空間構造をTransformerに伝えるための仕組みとして整理していきます。基本的なViTの位置埋め込みから、解像度が変わったときの工夫、さらに発展的な手法までを順に見ていきましょう。
1.画像をパッチに分割したときの位置情報
Vision Transformerは画像をどのように「トークン化」するのか
Transformerは文章を「単語(トークン)の並び」として受け取ります。では画像はどう渡すのか。ViTの答えはシンプルで、画像を同じ大きさのパッチに格子状に切り分け、単語の代わりに並べるというものです。
たとえば224×224ピクセルの画像を、16×16ピクセルのパッチに分割してみましょう。
縦方向: 224 ÷ 16 = 14
横方向: 224 ÷ 16 = 14
パッチ数: 14 × 14 = 196
画像は14行×14列、合計196個のパッチに分かれます。一般に、高さ $H$・幅 $W$ の画像を $P \times P$ のパッチに分けると、パッチ数 $N$ は次のようになります(縦横が割り切れる場合です)。
$$
N = \frac{H}{P} \times \frac{W}{P}
$$
各パッチは数値の一列(ベクトル)に平らに伸ばされ、線形変換を通して パッチ埋め込み に変換されます。これが文章でいう「単語の埋め込みベクトル」にあたり、ViTは画像を196個のパッチ埋め込みが並んだトークン列へと変換します。
パッチの並び順だけでは不十分なのか
パッチは左上から右下へ決まった順番で並びます。ならば「並べた順番」がそのまま位置情報になりそうですが、そうはいきません。Transformerの心臓部である Self-Attention は、すべてのパッチを互いに見比べてやりとりを計算する仕組みで、その計算式の中に「何番目のパッチか」という情報がそもそも入っていないのです。そのため、パッチを入れ替えて並べ直しても計算結果は対応して入れ替わるだけで、どのパッチが画像のどこにあったかは区別されません。Self-Attentionは入力を「順番のある列」ではなく「順序のない集合」のように扱う、と言い換えてもよいでしょう。
位置情報がないと何を見分けにくいのか
位置情報がないと何が困るのか、簡単な思考実験をしてみましょう。
たとえば、上半分に青空、下半分に草原が写った風景写真を考えます。この画像を小さなパッチに分けると、ViTには「青空が写ったパッチ」や「草原が写ったパッチ」が入力されます。
しかし、もし各パッチが画像内のどこにあったかという情報を持っていなければ、次の2つを区別しにくくなります。
通常の配置:
青空のパッチが上、草原のパッチが下
→ 自然な風景
入れ替え配置:
草原のパッチが上、青空のパッチが下
→ 不自然な風景
どちらの画像にも、「青空のパッチ」と「草原のパッチ」そのものは含まれています。違うのは、それらが上にあるのか、下にあるのかという配置だけです。
つまり、位置情報がないと、モデルは「何が写っているか」は分かっても、「それがどこにあるか」や「他のものとどのような位置関係にあるか」を判断しにくくなります。画像認識では、物体の種類だけでなく、上下左右、近さ、並び方といった空間的な関係も重要です。位置エンコーディングは、この空間的な手がかりをTransformerに与えるための仕組みだと考えられます。
では、ViTはこの196枚のパッチにどんな「住所」を渡しているのでしょうか。
2.ViTはパッチへ位置情報をどう加えるのか
学習可能な位置埋め込み
ViTの解決策は素直です。各パッチの「中身」を表すパッチ埋め込みとは 別に、各位置の「住所」を表すベクトルを用意し、それを足し込みます。この住所にあたるベクトルを 位置埋め込み(Positional Embedding) と呼びます。
つまり、ViTに入力される各パッチのベクトルは、次のように作られます。
入力ベクトル = パッチ埋め込み + 位置埋め込み
パッチ埋め込みは「何が写っているか」を表し、位置埋め込みは「それがどこにあるか」を表します。この2つを足し合わせることで、Transformerはパッチの内容だけでなく、画像内での位置も考慮できるようになります。
初期のViTの特徴は、この位置埋め込みを 学習可能(learnable) にしたことです。これは、位置ごとのベクトルをあらかじめ決められた数式で作るのではなく、モデルの他の重みと同じように、学習を通じて更新していくという意味です。
Transformer原論文[1]で使われたサイン・コサイン型の位置エンコーディングは、位置ベクトルを固定の式によって計算する方法でした。それに対してViTでは、「1番目のパッチにはこの位置ベクトル、2番目のパッチにはこの位置ベクトル」というように、各位置に対応するベクトルの表を用意し、その値をデータから学習します。
位置埋め込みは何を手がかりに学習されるのか
「学習する」と言われても、最初は具体的なイメージが湧きにくいかもしれません。固定式なら計算すれば値が決まりますが、学習可能な位置埋め込みは どこから出発し、何を頼りに、どう更新されていく のでしょうか。順を追って見てみましょう。
出発点は、意味を持たない ランダムな値 です。学習を始める前の位置埋め込みでは、各位置に適当な数字の並びが割り当てられているだけで、「1番目の住所」と「2番目の住所」のあいだに明確な規則性はありません。まだ意味づけされていない住所ラベルに、でたらめな数字が書かれている状態だと考えるとよいでしょう。
ここからの更新は、ニューラルネットワークの一般的な学習と同じ 誤差からのフィードバック で進みます。流れはおおよそ次の通りです。
1. 大量の「画像と正解ラベル」の組をモデルに与える
2. 現在の位置埋め込みを使って画像を分類し、予測を出す
3. 予測と正解のズレ(誤差)を測る
4. 誤差を小さくするには各値をどう動かせばよいかを逆算する(誤差逆伝播)
5. 位置埋め込みを含むすべての重みを、その向きへほんの少し更新する
6. 1〜5を何度も繰り返す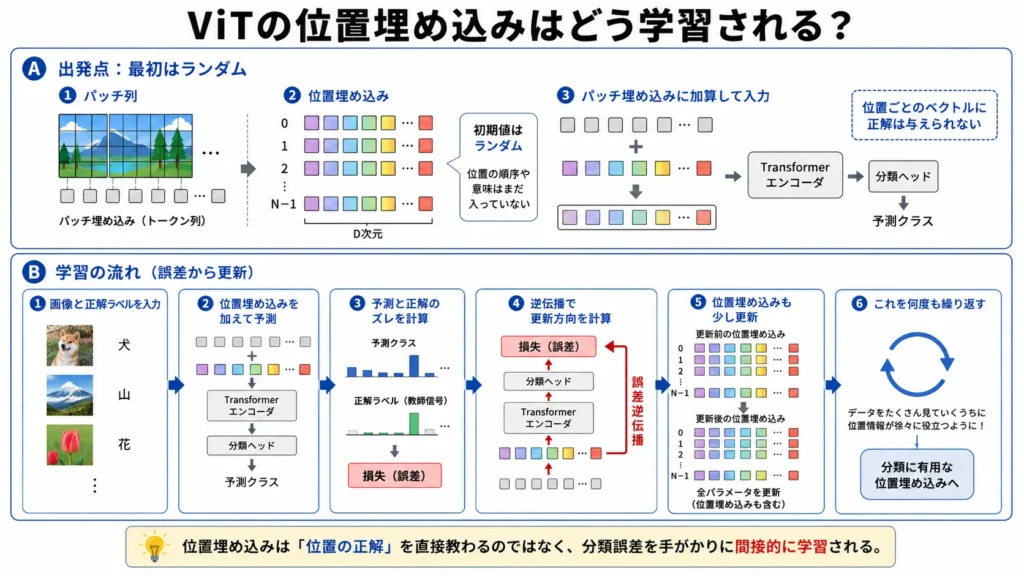
ここで大切なのは、位置埋め込みに「正解の住所」を直接教える人はいないという点です。「この位置の住所はこのベクトルにしなさい」という手本は与えられません。モデルが受け取る唯一の圧力は「最終的な分類をもっと当てられるようにせよ」というものだけです。位置埋め込みは、その目的に貢献できる値へと間接的に押し動かされていきます。
そして、まさにこの「目的に役立つ値へ間接的に育つ」性質が、次に見る 2次元画像を1列の位置埋め込みで扱える という不思議な事実の伏線になります。
パッチ埋め込みと位置埋め込みはどう組み合わされるのか
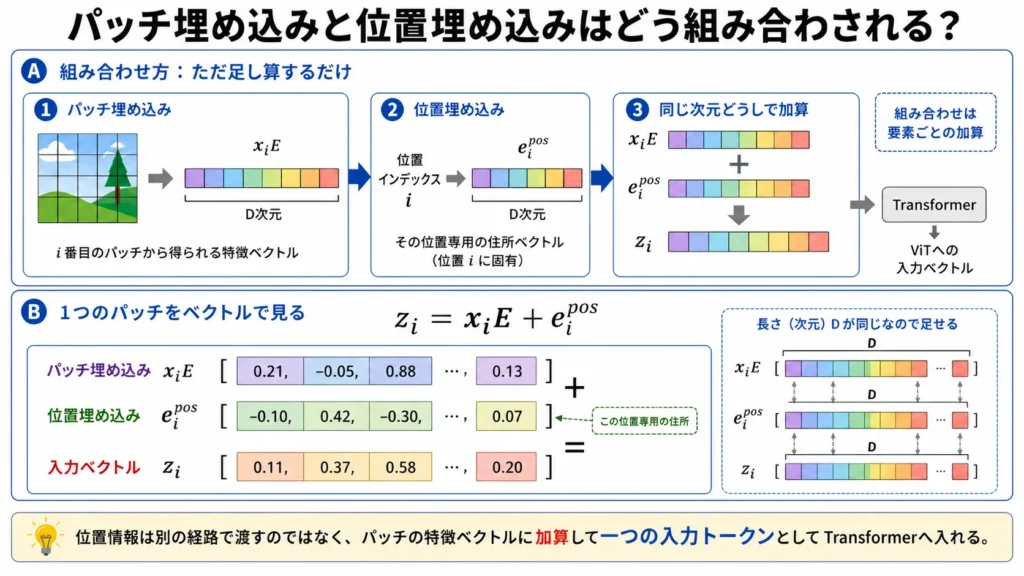
組み合わせ方は、文章での位置埋め込みと同じく ただ足し算するだけです。$i$ 番目のパッチについて、パッチ埋め込みとその位置専用の位置埋め込みを、同じ次元どうしで加算します。
$$
z_i = x_i E + e_i^{\mathrm{pos}}
$$
$x_i$ は $i$ 番目のパッチを1次元に伸ばしたベクトル、$E$ はそのベクトルをTransformerで扱う埋め込み次元へ写すための学習可能な線形変換です。したがって、$x_i E$ は「パッチそのもの」ではなく、パッチの画素情報をTransformer用の長さに変換した パッチ埋め込み を表します。一方、$e_i^{\mathrm{pos}}$ は「このパッチは $i$ 番目の位置にある」という情報を表す、その位置専用の学習可能な位置埋め込みです。$x_i E$ と $e_i^{\mathrm{pos}}$ は同じ長さのベクトルなので、下の図のように要素ごとに足し合わせられます。
なお、ViTでは画像全体をまとめて表す特別な [CLS] トークン(分類用トークン)を列の先頭に加えるのが一般的です。これは文章でいう「要約役」のトークンで、最終的にこの1本のベクトルを手がかりに画像分類の判断を下します。[CLS] トークンにも位置埋め込みが1つ割り当てられるため、位置埋め込み全体の形は概念的に $(N+1) \times D$ となります。$N$ はパッチ数、$D$ は埋め込みの次元、「$+1$」が [CLS] トークンの分です。
2次元画像なのに、なぜ1列の位置埋め込みで扱えるのか
ここで少し意外な事実があります。画像は縦と横を持つ2次元なのに、原論文のViTが標準構成で使ったのは、行と列を別々に扱う2次元的な位置埋め込みではなく、1列に並べた番号に対応する「1次元の」位置埋め込みでした。
1次元位置埋め込み : パッチを 0, 1, ... , 195 の1列の番号として扱い、
                   それぞれに住所ベクトルを1つずつ用意する
2次元位置埋め込み : 「行用の住所」と「列用の住所」を別々に学習し、組み合わせる
パッチは決まった順番で並ぶので、「列上の番号」と「元の画像での行・列の座標」はきちんと対応します。14列の画像なら番号15のパッチは「2行目の2列目」と一意に決まり、1列の番号さえあれば画像上の場所は復元できるのです。
では、なぜ2次元的な方式を使わなかったのか。原論文では位置情報なし・1次元・2次元・相対位置が比較され、位置情報を与えない場合は性能が大きく落ちる一方、与える方式どうしの差はごくわずかでした。高度な2次元方式に明確な利点が見られなかったため、最も単純な1次元方式が標準に採用されたのです。著者らは、画素単位ではなく大きなパッチ単位で処理するため、符号化方式の細かな違いが効きにくかった可能性を述べています。
「1次元方式が理論的に最良だ」「現在のすべてのViTで1次元が標準だ」とは一般化しないでください。あくまで「原論文の設定では単純な方式で十分だった」という話です。
興味深いのはその先です。教えていない空間構造が、学習を通じてデータから自然に立ち上がってきます。 学習可能な位置埋め込みはランダムな値から出発し、「この次元が行、この次元が列」といった構造を一切教わっていません。それでも学習後に分析すると、画像内で近いパッチどうしのベクトルは似た値になり、同じ行・列のパッチには規則的な構造が現れたと報告されています。
ただし、空間構造を担うのは位置埋め込みだけではありません。パッチ分割や学習データ、Attentionを含むモデル全体が協調しており、位置埋め込みはその重要な入口だと捉えるのが正確です。
14×14個の位置を学習すれば224×224の画像は扱えます。しかし、もっと大きく高精細な画像を入れたら、パッチが増えて住所の数が足りなくなってしまいます。
3.画像の解像度が変わると何が起こるのか
パッチ数が変わると、なぜ学習済みの位置埋め込みを使えないのか
パッチサイズを16のまま、入力を224×224から384×384へ大きくすると、パッチ数は次のように変わります。
224 × 224、パッチ16 → 14 × 14 = 196 パッチ
384 × 384、パッチ16 → 24 × 24 = 576 パッチ
学習可能な位置埋め込みは「学習時のパッチ数ぴったりの住所ベクトルの束」でした。224×224で学習したモデルは196個分の住所しか持たないので、576個のパッチには380個分の住所が足りません。
ここで区別したいのは、Transformer本体はメモリさえ許せば196個でも576個でも違う長さの列を処理できる、という点です。困るのは本体ではなく、位置数に固く結びついた学習済みの位置埋め込みのほうなのです。
位置埋め込みの補間は何をしているのか
足りない住所を一からランダムに作り直しては、学習した位置の構造が台無しになります。そこで使うのが 補間(interpolation)、既にある値の「あいだ」を近くの値から滑らかに推定して埋める操作です。
ポイントは、補間する対象が 入力画像でもAttentionマップでもなく、位置ベクトルが並んだ格子 だということです。1列の位置埋め込みをいったん14×14の格子へ戻し、24×24へ引き伸ばしてから、再び1列に並べ直します。
1. [CLS] トークン用の住所ベクトルを脇へ分離する
2. 196 × D の位置埋め込みを 14 × 14 × D の格子に戻す
3. 格子を 24 × 24 × D へ補間して引き伸ばす
4. 576 × D の1列に並べ直す
5. 脇に置いた [CLS] 用ベクトルを先頭へ結合する
[CLS] トークンの住所は画像格子上に位置を持たないため、補間の前に分離して後で戻すのが一般的です。
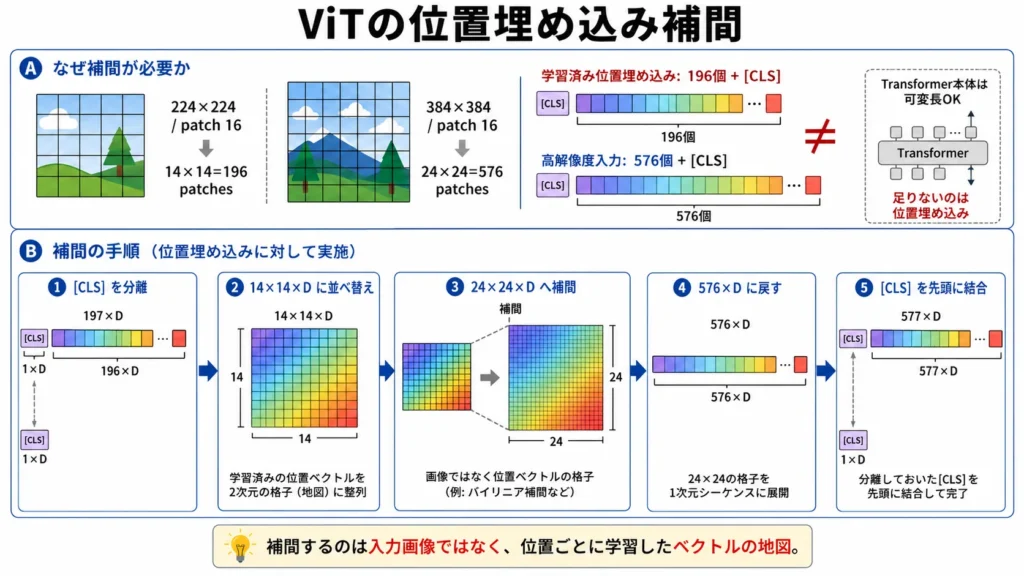
イメージとしては、14×14の升目に色のグラデーションが描かれた地図を、24×24へ拡大コピーする様子に近いものです。新しく増えた升目の色は、まわりの色から滑らかに補われます。ViTがやっているのもこれと同じ「住所の地図の拡大」で、拡大しているのは写真そのものではなく 位置ごとに学習したベクトルの地図 だ、という点が肝心です。
補間すれば、どんな解像度でも問題ないのか
便利な補間も万能ではありません。保証してくれるのは「住所の数を新しいパッチ数に合わせられる」ことだけで、学習時から大きく離れた解像度での性能維持や、任意の縦横比への適応、細かな位置関係の完全な保存までは保証しません。
計算コストも見落とされがちです。標準的なViTは全パッチどうしでAttentionを計算するため、計算量はパッチ数 $N$ に対しおおよそ $N^2$ に比例します。224から384への例ではパッチ数が196から576へ約2.94倍になるので、
(576 / 196)^2 ≈ 8.64Attention行列の要素数は単純計算で約8.64倍にもなります。これは補間の失敗ではなく、入力列が長くなったこと自体による計算量の問題です。「位置の数を合わせられる」ことと「安いコストで高解像度化できる」ことは別だと整理しておきましょう。
補間の具体的なアルゴリズム(線形補間か bicubic か、
align_cornersの設定など)は実装によって異なり、ViT全般で統一されてはいません。本記事では「2次元格子として補間する」という考え方を押さえれば十分です。
4.画像の位置表現の発展
学習可能な絶対位置埋め込みは「このパッチは何番目(どの住所)か」を各位置に持たせる考え方でした。これを出発点に、画像向けの位置表現はいくつかの方向へ発展しています。ここでは数式に深入りせず、それぞれが「どんな課題に応えようとしているか」を見ていきましょう。
絶対位置だけでは何が足りないのか
絶対位置は「各パッチの住所」を与えますが、画像認識で効いてくるのはむしろ パッチ同士の関係 です。「右隣にある」「2つ下にある」といった相対的な距離や方向は、絶対的な住所からは間接的にしか読み取れません。そこで、住所そのものではなく 二つのパッチの位置関係 を直接Attentionへ伝えようという発想が生まれます。
パッチ同士の相対位置を表現する
この発想を分かりやすく形にしたのが、階層型ViTの一つ Swin Transformer の 相対位置バイアス です。Swinは画像全体ではなく局所的なウィンドウの中でAttentionを計算し、その際「ウィンドウ内で2つのパッチが縦・横にどれだけずれているか」に応じた学習可能なバイアスをAttentionスコアへ加えます。絶対位置が「各パッチの住所ラベル」なら、相対位置バイアスは「二地点がどれだけ離れているか」に応じて注目の強さを調整する仕組みだとイメージできます。
2次元RoPE
相対位置バイアスが「Attentionスコアに下駄を履かせる」方式だったのに対し、もう一つ、比較の計算そのものに位置を仕込んでしまう発想があります。それが、文章向けでも広く使われる RoPE(回転位置埋め込み) を画像へ拡張した 2次元RoPE です。RoPEは位置に応じた「回転」をAttentionのQuery・Keyへ施し、内積(パッチ同士の比較)の中に相対的な位置差が自然に現れるようにします。位置ベクトルを足すのではなく、比較の計算そのものに位置を織り込む別系統のアプローチです。代表的な方式は複数あり、縦座標と横座標へ別々に回転を適用する Axial方式 や、斜め方向まで扱えるよう軸を混ぜた Mixed方式 などが提案されています。たとえばRoPE-ViTの研究では、224×224ピクセルで学習したViTをより大きい解像度で評価したとき、2次元RoPEが学習可能な絶対位置埋め込みより良い「解像度の外挿」性能を示した例が報告されています[2]。
まとめ
今回の要点を振り返りましょう。
- ViTは画像をパッチに分けて1列に並べるため、中身とは 別に 元の位置を伝える必要がある
- 原始的なViTは、学習可能な1次元の絶対位置埋め込み をパッチ埋め込みへ足し込んでこれを解決した
- 解像度が変わってパッチ数が変わるときは、位置埋め込みを 2次元の格子として補間 して数を合わせる
- 相対位置表現や2次元RoPEは、パッチ間の距離や方向をより直接的にAttentionへ反映しようとする発展である
位置エンコーディングは「画像に番号を振るだけの付属品」ではなく、パッチへ分割した瞬間に失われる 空間構造を、Transformerへもう一度伝えるための設計そのもの です。ViTがどの位置表現を選ぶかは、その画像をどう理解させたいかという設計思想の表れなのです。
参考文献
[1] Vaswani, Ashish, et al. “Attention is all you need.” Advances in neural information processing systems 30 (2017).
[2] Heo, B., Park, S., Han, D., & Yun, S. (2024). Rotary Position Embedding for Vision Transformer. arXiv:2403.13298.